Содержание статьи
В распределённых системах адрес сервиса перестаёт быть фиксированным значением. Контейнеры пересоздаются, поды масштабируются, IP-адреса меняются при каждом деплое или сбое узла. Жёстко заданные конфигурации приводят к ошибкам маршрутизации, простоям и ручным правкам. Service discovery решает эту проблему за счёт динамического обнаружения сервисов и автоматического обновления информации об их доступности.
На практике service discovery представляет собой механизм сопоставления логического имени сервиса с актуальным набором его экземпляров. Каждый сервис при запуске регистрируется в реестре, передавая адрес, порт и состояние. Клиенты или промежуточные компоненты получают эти данные в момент обращения, а не из конфигурационных файлов. Такой подход позволяет масштабировать систему без изменения кода и без перезапуска зависимых компонентов.
При проектировании архитектуры важно заранее определить модель взаимодействия: клиентский или серверный способ обнаружения, формат health-check, политику обновления данных и стратегию реакции на недоступность экземпляров. Неправильный выбор приводит к избыточному сетевому трафику, задержкам при поиске сервисов и усложнению отладки. Поэтому service discovery рассматривается не как вспомогательный инструмент, а как базовый инфраструктурный слой микросервисной среды.
В современных системах service discovery тесно связан с оркестраторами, балансировщиками и системами наблюдаемости. Он влияет на маршрутизацию запросов, распределение нагрузки и устойчивость к сбоям. Понимание принципов его работы позволяет корректно настраивать масштабирование, избегать каскадных отказов и прогнозировать поведение системы при изменении числа сервисов.
Service discovery: что это и как работает
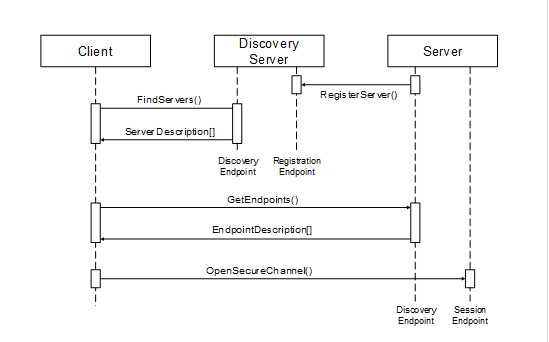
Работа service discovery начинается с регистрации. При запуске сервис отправляет в реестр своё логическое имя, сетевые координаты, метаданные и статус. Далее с заданным интервалом выполняются проверки доступности: либо сам сервис подтверждает работоспособность, либо реестр опрашивает его через health-check. Если экземпляр перестаёт отвечать, он автоматически исключается из списка доступных.
Поиск сервиса выполняется в момент запроса. Клиент получает из реестра набор актуальных адресов и выбирает один из них по заданной стратегии, либо запрос проходит через промежуточный компонент, который берёт эту задачу на себя. Такой процесс устраняет необходимость перезапуска приложений при изменении топологии и снижает риск обращения к недоступным узлам.
Для корректной работы service discovery рекомендуется ограничивать объём данных в реестре только необходимыми параметрами, настраивать короткие интервалы проверки состояния и использовать уникальные имена сервисов, не зависящие от среды развертывания. Это упрощает масштабирование, ускоряет диагностику проблем и делает поведение системы предсказуемым при росте нагрузки.
Какие проблемы микросервисной архитектуры решает service discovery
В микросервисной архитектуре каждый сервис разворачивается и масштабируется независимо, из-за чего его сетевые координаты становятся нестабильными. Использование статических IP-адресов или DNS-записей приводит к ошибкам соединения после перезапуска контейнеров, автоскейлинга или миграции узлов. Service discovery устраняет эту зависимость, предоставляя актуальные адреса сервисов в момент обращения.
Вторая ключевая проблема – обращение к недоступным экземплярам. Без механизма обнаружения клиент продолжает отправлять запросы на сервис, который уже завершил работу или находится в некорректном состоянии. Service discovery исключает такие экземпляры из реестра на основе проверок состояния, что снижает количество сетевых ошибок и повторных запросов.
Также service discovery решает задачу координации масштабирования. При увеличении числа экземпляров сервиса новые узлы автоматически становятся доступными для клиентов без изменения конфигурации. Это особенно важно при пиковых нагрузках, когда ручное управление списком адресов становится источником задержек и сбоев.
Дополнительно service discovery упрощает изоляцию сред. Одинаковые имена сервисов могут использоваться в тестовой, staging и production-среде, так как реестр хранит данные в рамках конкретного окружения. Это снижает риск ошибочного обращения к внешним ресурсам и упрощает автоматизацию деплоя.
| Проблема | Последствия без service discovery | Результат применения |
|---|---|---|
| Динамические IP-адреса | Сбои соединений после перезапуска сервисов | Актуальные адреса при каждом запросе |
| Недоступные экземпляры | Ошибки и тайм-ауты на стороне клиентов | Автоматическое исключение из маршрутизации |
| Горизонтальное масштабирование | Необходимость ручного обновления конфигураций | Автоматическое подключение новых экземпляров |
Чем отличается клиентский и серверный подход к service discovery
Клиентский подход предполагает, что логика обнаружения сервисов встроена непосредственно в приложение-потребитель. Клиент обращается к реестру сервисов, получает список доступных экземпляров и самостоятельно выбирает адрес для запроса. Такой вариант требует наличия библиотек service discovery в каждом сервисе и согласованной версии протоколов доступа к реестру.
При клиентском подходе важно учитывать нагрузку на реестр и поведение клиентов при частых изменениях состояния сервисов. Рекомендуется использовать локальное кэширование результатов поиска и обновлять данные по событийному принципу или с ограниченным интервалом. Без этого возрастает количество сетевых запросов и сложность отладки логики маршрутизации.
- Логика выбора экземпляра находится в коде клиента
- Требуется интеграция с реестром в каждом сервисе
- Балансировка выполняется на стороне приложения
Серверный подход выносит обнаружение сервисов в отдельный инфраструктурный компонент. Клиент отправляет запрос на фиксированную точку входа, а промежуточный сервис получает данные из реестра и перенаправляет запрос на подходящий экземпляр. В этом случае клиент не знает о количестве и адресах сервисов.
- Клиенты используют единый адрес для всех запросов
- Обнаружение и выбор экземпляра выполняется централизованно
- Обновление логики не требует изменения клиентского кода
При выборе подхода рекомендуется учитывать масштаб системы и требования к управлению зависимостями. Клиентский вариант подходит для простых архитектур с ограниченным числом сервисов, тогда как серверный упрощает поддержку крупных систем и снижает связность между компонентами.
Как сервисы регистрируются и удаляются из реестра
После регистрации сервис поддерживает своё присутствие в реестре через периодические подтверждения активности. На практике применяются два подхода: отправка heartbeat-сообщений самим сервисом или внешняя проверка доступности через HTTP или TCP. Если подтверждение не получено в установленный интервал, экземпляр помечается как недоступный и исключается из списка кандидатов для обработки запросов.
Удаление сервиса из реестра происходит автоматически или явно. При корректном завершении работы сервис отправляет запрос на дерегистрацию, что позволяет мгновенно убрать его из маршрутизации. В аварийных ситуациях используется тайм-аут отсутствия активности, после которого реестр самостоятельно очищает запись, предотвращая обращения к несуществующему адресу.
Для надёжной работы рекомендуется регистрировать сервис только после завершения инициализации и подключения зависимостей, а дерегистрацию выполнять до остановки сетевых интерфейсов. Это снижает вероятность отправки запросов на экземпляры, которые ещё не готовы принимать трафик или уже завершили работу.
Какие данные хранятся в реестре сервисов и как они используются
Реестр сервисов содержит минимально необходимый набор сведений для маршрутизации запросов и контроля доступности. Базовыми полями считаются логическое имя сервиса, уникальный идентификатор экземпляра, IP-адрес и порт. Эти данные позволяют сопоставить запрос с конкретным запущенным процессом без обращения к конфигурационным файлам.
Помимо сетевых параметров в реестр часто добавляются метаданные, описывающие свойства сервиса. К ним относятся версия API, протокол взаимодействия, регион размещения, зона отказа и теги среды выполнения. Эти значения используются клиентами и прокси для фильтрации неподходящих экземпляров и выбора совместимых вариантов.
Отдельную роль играет информация о состоянии. В реестре хранится текущий статус экземпляра, временные метки последнего подтверждения активности и результаты проверок здоровья. На основе этих данных принимается решение о включении сервиса в маршрутизацию или его временном исключении.
При проектировании схемы данных рекомендуется избегать хранения вычисляемых или быстро меняющихся показателей. Реестр должен содержать только сведения, необходимые для обнаружения и выбора сервиса. Избыточные поля увеличивают нагрузку на синхронизацию и усложняют поддержку. Чёткое разделение между данными обнаружения и метриками упрощает масштабирование и снижает риск рассинхронизации.
Как происходит поиск и выбор доступного экземпляра сервиса
Поиск сервиса начинается с обращения по его логическому имени. Клиент или промежуточный компонент отправляет запрос в реестр и получает список экземпляров, помеченных как доступные на текущий момент. В ответе учитываются данные о состоянии, времени последнего подтверждения активности и заданные фильтры по метаданным.
После получения списка выполняется этап отбора. На этом шаге исключаются экземпляры, не подходящие по версии API, зоне размещения или другим заданным параметрам. Такой предварительный отбор снижает вероятность ошибок совместимости и сокращает время на повторные попытки соединения.
- Фильтрация по статусу и метаданным
- Исключение недавно восстановившихся экземпляров
- Ограничение выбора в рамках одной зоны отказа
Выбор конкретного адреса осуществляется по заданному алгоритму. Чаще всего применяется циклический перебор или случайный выбор, но возможна и привязка к контексту запроса. Важно, чтобы стратегия была детерминированной и не требовала дополнительных обращений к реестру при каждом запросе.
- Получение списка доступных экземпляров
- Применение правил отбора
- Выбор адреса для отправки запроса
Для стабильной работы рекомендуется кэшировать результаты поиска и обновлять их при изменении состояния сервисов. Это уменьшает нагрузку на реестр и снижает задержки при высоком количестве запросов, сохраняя актуальность маршрутизации.
Как service discovery взаимодействует с балансировкой нагрузки
Service discovery и балансировка нагрузки работают как связанные, но логически разделённые механизмы. Реестр сервисов отвечает за предоставление актуального списка доступных экземпляров, а балансировщик использует эти данные для распределения входящих запросов. Без service discovery балансировщик опирается на статическую конфигурацию, что делает его зависимым от ручных обновлений.
При интеграции с service discovery балансировщик получает изменения состава сервисов в режиме близком к реальному времени. Новые экземпляры добавляются в пул сразу после регистрации, а недоступные исключаются при потере статуса активности. Это позволяет перераспределять трафик без перезапуска и без вмешательства в конфигурацию.
Ключевой момент взаимодействия – точка принятия решения. В одних архитектурах выбор экземпляра происходит на стороне клиента, и балансировка реализуется библиотекой внутри приложения. В других случаях используется внешний прокси, который объединяет функции обнаружения и распределения нагрузки, скрывая эту логику от клиентов.
Рекомендуется согласовывать параметры проверок состояния между реестром и балансировщиком. Несовпадение интервалов и критериев может привести к ситуации, когда экземпляр уже исключён из реестра, но всё ещё получает трафик. Единые правила оценки доступности снижают количество ошибок и делают маршрутизацию предсказуемой при изменении нагрузки.
Как обеспечивается отказоустойчивость при недоступности сервисов
Отказоустойчивость в service discovery достигается за счёт постоянного контроля состояния сервисов и автоматического обновления данных в реестре. Каждый экземпляр либо регулярно подтверждает свою работоспособность, либо проверяется внешним механизмом. При отсутствии ответа в заданный интервал запись помечается как недоступная и исключается из маршрутизации.
Важную роль играет временной порог удаления. Слишком короткий тайм-аут приводит к частым исключениям при кратковременных сбоях, а слишком длинный – к отправке запросов на неработающие экземпляры. Рекомендуется подбирать значения с учётом времени запуска сервиса, сетевых задержек и ожидаемой нагрузки.
Для предотвращения каскадных отказов используется избыточность. Реестр хранит несколько доступных экземпляров одного сервиса, а клиенты или прокси автоматически переключаются на альтернативный адрес при ошибке соединения. Это позволяет продолжать обработку запросов даже при частичном выходе системы из строя.
Дополнительно отказоустойчивость усиливается за счёт репликации самого реестра сервисов. При недоступности одного узла данные остаются доступными через другие реплики, что исключает зависимость всей системы от единой точки отказа. Такой подход поддерживает стабильную маршрутизацию даже при сбоях инфраструктурных компонентов.
Какие инструменты service discovery применяются на практике

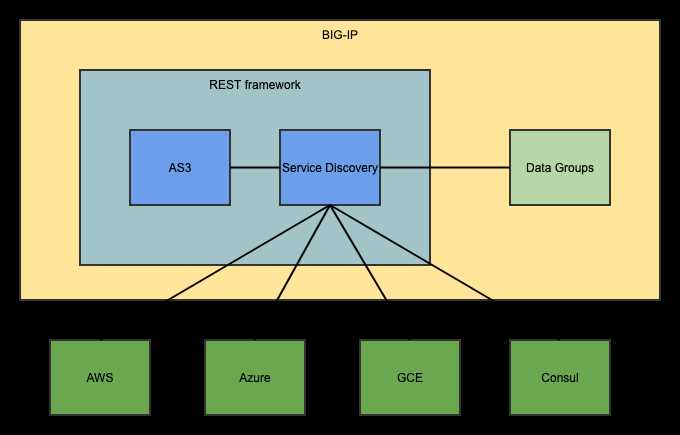
На практике service discovery реализуется либо как отдельный инфраструктурный сервис, либо как встроенный механизм оркестратора. Выбор инструмента зависит от способа развертывания, требований к отказоустойчивости и степени контроля над сетевым взаимодействием. В большинстве случаев используются готовые решения, уже адаптированные под динамическую среду.
Для самостоятельного управления реестром сервисов применяются специализированные системы, которые обеспечивают регистрацию, проверки состояния и хранение метаданных. Они требуют явной интеграции на уровне приложений, но дают полный контроль над логикой обнаружения и структурой данных.
В контейнерных средах service discovery часто реализуется на уровне платформы. Оркестратор автоматически отслеживает жизненный цикл сервисов и обновляет информацию о доступных экземплярах, избавляя разработчиков от необходимости ручной регистрации и дерегистрации.
При выборе инструмента рекомендуется учитывать объём кластера, частоту изменений состава сервисов и требования к сетевой изоляции. В небольших системах оправдан минимальный набор функций, тогда как в крупных распределённых средах важны репликация реестра и интеграция с балансировкой.
| Инструмент | Тип использования | Особенности |
|---|---|---|
| Consul | Отдельный реестр сервисов | Поддержка health-check и распределённого хранилища |
| etcd | Координационное хранилище | Используется как основа для собственных решений |
| Kubernetes Service | Встроенный механизм | Автоматическое обнаружение через DNS и API |
| ZooKeeper | Распределённая координация | Подходит для систем с высокой согласованностью |
Вопрос-ответ:
Зачем нужен service discovery, если в системе уже используется DNS?
DNS решает задачу сопоставления имени и адреса, но не отслеживает состояние отдельных экземпляров сервиса. В микросервисной среде контейнер может быть запущен, но не готов принимать запросы, или завершить работу без корректного обновления DNS-записи. Service discovery учитывает статус, время последнего отклика и метаданные, поэтому клиенты получают только рабочие адреса, а не просто список записей.
Что произойдёт, если реестр service discovery станет недоступным?
При корректной настройке клиенты используют кэш последних данных и продолжают работу до истечения времени их актуальности. Сам реестр разворачивается в виде кластера с репликацией данных, поэтому отказ одного узла не приводит к потере информации. Проблемы начинаются, если система построена вокруг одиночного экземпляра без резервирования.
Нужно ли каждому сервису знать о service discovery напрямую?
Это зависит от выбранной архитектуры. При клиентском подходе сервисы действительно взаимодействуют с реестром напрямую и содержат соответствующую логику. При серверном варианте обнаружение и выбор адреса выполняются прокси или балансировщиком, а сервисы работают с фиксированной точкой входа и не зависят от механизма обнаружения.
Как service discovery влияет на процесс масштабирования?
При добавлении новых экземпляров сервиса они регистрируются в реестре сразу после запуска и становятся доступны для обработки запросов без изменения конфигураций. Аналогично, при уменьшении количества экземпляров записи удаляются автоматически. Это позволяет масштабировать систему без остановки зависимых компонентов и без ручного управления списками адресов.
Можно ли использовать service discovery вне контейнерных платформ?
Да, service discovery применяется и в виртуальных машинах, и в физических кластерах. В таких случаях регистрация и проверки состояния настраиваются на уровне приложений или агентов. Контейнерные платформы лишь автоматизируют этот процесс, но сам подход не привязан к конкретному способу развертывания.
Чем service discovery отличается от жёстко заданных адресов в конфигурации?
При статической конфигурации адреса сервисов задаются заранее и требуют обновления при каждом изменении инфраструктуры. Это создаёт риск обращения к несуществующим узлам после перезапуска или масштабирования. Service discovery хранит актуальные сведения о доступных экземплярах и предоставляет их в момент запроса, поэтому изменение количества сервисов не требует правок конфигураций и перезапуска приложений.
Как service discovery помогает избежать ошибок при деплое новых версий сервиса?
Новый экземпляр регистрируется в реестре только после запуска и прохождения проверок состояния. Пока сервис не подтвердил готовность, он не участвует в маршрутизации. При остановке старой версии запись удаляется или помечается как недоступная. Такой порядок снижает риск отправки запросов на сервисы, которые ещё не готовы обрабатывать трафик или уже завершили работу.

 Загрузка...