Содержание статьи
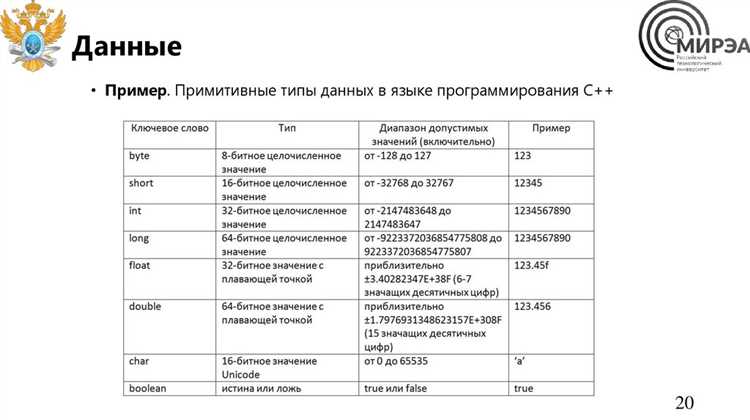
В современных реляционных базах данных выбор типа поля для текстовой информации напрямую влияет на производительность и масштабируемость. Стандартные типы, такие как CHAR и VARCHAR, подходят для строк фиксированной и переменной длины соответственно. CHAR резервирует указанное количество символов независимо от фактической длины строки, что ускоряет операции чтения, но может приводить к перерасходу памяти.
VARCHAR экономит пространство, храня только фактические символы плюс небольшой служебный объем, но при частых обновлениях длины строки возможны дополнительные накладные расходы на перераспределение памяти. Для хранения больших объемов текста применяются типы TEXT и его разновидности: TINYTEXT, MEDIUMTEXT, LONGTEXT. Они оптимизированы под хранение от нескольких килобайт до гигабайт, но индексирование таких полей ограничено по размеру, поэтому их лучше использовать для редко фильтруемых данных.
При проектировании структуры базы важно учитывать требования к индексации и частоте обновлений. Для полей, активно участвующих в поиске и сортировке, предпочтительнее использовать VARCHAR с четко определенной максимальной длиной. TEXT-поля эффективны для хранения логов, описаний или больших блоков документации, когда скорость выборки вторична по сравнению с вместимостью.
Кроме того, современные СУБД поддерживают JSON и XML как специальные текстовые типы, позволяющие хранить структурированные данные. Они обеспечивают встроенные функции поиска по ключам и встраивание в индексы, но требуют тщательного проектирования схемы и оптимизации запросов для минимизации нагрузки на сервер.
CHAR и VARCHAR: когда выбирать фиксированную или переменную длину
Тип CHAR предназначен для хранения строк фиксированной длины. При задании CHAR(10) каждый элемент всегда занимает 10 символов, даже если фактическая длина строки меньше. Это обеспечивает предсказуемое использование памяти и высокую скорость доступа при обработке больших массивов однотипных данных, например, кодов стран, статусов или идентификаторов фиксированной длины.
Тип VARCHAR хранит строки переменной длины и использует память только под фактическое количество символов плюс один-два байта для хранения длины. Например, VARCHAR(50) может хранить строки длиной от 0 до 50 символов, занимая память пропорционально реальной длине строки. Это экономит место при разнообразных текстовых данных, таких как имена пользователей, email-адреса или комментарии.
Рекомендации по выбору:
- Используйте CHAR, когда длина данных всегда одинаковая или отличается незначительно. Это ускоряет поиск и индексирование, так как строки фиксированной длины проще сравнивать.
- Выбирайте VARCHAR для переменных по длине полей, где экономия памяти критична и строки могут сильно различаться по размеру.
- Не применяйте CHAR для длинных текстов: каждый символ резервируется, что увеличивает размер базы и снижает производительность при обновлениях.
- Для небольших текстовых данных, которые часто меняются, VARCHAR уменьшает накладные расходы и снижает фрагментацию таблиц.
- Если индексируемые поля имеют высокую вариативность длины, VARCHAR позволяет эффективнее хранить индексы и уменьшает нагрузку на диск.
Практический пример: коды стран или штатные идентификаторы всегда лучше хранить в CHAR, тогда как адреса, описания товаров и комментарии лучше помещать в VARCHAR.
Выбор между CHAR и VARCHAR напрямую влияет на производительность чтения, запись и объем базы. Для высоконагруженных систем с предсказуемой длиной данных предпочтителен CHAR, для гибких и разнородных данных – VARCHAR.
TEXT и CLOB: хранение больших объёмов текста
Типы данных TEXT и CLOB предназначены для хранения текста, превышающего стандартные размеры VARCHAR. В MySQL поле TEXT может содержать до 65 535 байт, MEDIUMTEXT – до 16 777 215 байт, а LONGTEXT – до 4 294 967 295 байт. В Oracle и других СУБД используется CLOB, способный хранить до 4 гигабайт текста в одной записи.
TEXT и CLOB не индексируются полноценно как короткие строки. Для ускорения поиска рекомендуется создавать отдельные полнотекстовые индексы или использовать внешние поисковые движки, например Elasticsearch. Использование обычных индексов на таких полях может замедлить операции вставки и обновления.
При проектировании таблиц важно учитывать, что данные в TEXT/CLOB часто хранятся вне основной строки, ссылаясь на LOB-структуры. Это снижает нагрузку на память при выборке стандартных полей, но увеличивает время доступа при чтении больших фрагментов текста.
Для оптимизации работы с большими текстами рекомендуется разбивать данные на логические части или использовать сжатие. В PostgreSQL можно применять тип TEXT совместно с функцией TO_TSVECTOR для полнотекстового поиска без внешних инструментов.
При обновлении больших полей стоит избегать частых модификаций полного содержимого. Лучше использовать подходы с версионностью или хранить новые фрагменты отдельно, минимизируя блокировки LOB и снижая нагрузку на транзакционную систему.
TEXT и CLOB подходят для хранения документов, описаний, логов и JSON, превышающих ограничения стандартных строковых типов. При проектировании базы важно балансировать между размером текста, индексированием и частотой обновлений, чтобы обеспечить стабильную производительность.
NVARCHAR и NCHAR: поддержка многоязычных данных
NCHAR и NVARCHAR предназначены для хранения текстовой информации в форматах Unicode, что обеспечивает корректное отображение символов разных языков, включая азиатские, арабские и специальные символы. NCHAR использует фиксированную длину: если задано NCHAR(50), каждый текст будет занимать ровно 50 символов, а незаполненные позиции автоматически дополняются пробелами. Это удобно для данных с предсказуемой длиной, но увеличивает объем хранимой информации при коротких строках.
NVARCHAR поддерживает переменную длину, что экономит пространство: строка NVARCHAR(100) может занимать от 1 до 100 символов в зависимости от фактической длины текста. Рекомендуется использовать NVARCHAR для полей с динамичным содержимым, например, комментариев, имен пользователей или адресов, где длина текста существенно варьируется.
Для обоих типов важно учитывать UTF-16 кодировку, где один символ занимает 2 байта. Это влияет на расчет максимального объема данных и выбор индексов. NVARCHAR лучше индексировать при больших объемах данных, так как индексация NCHAR фиксированной длины может создавать лишние затраты памяти.
При проектировании базы данных с многоязычными интерфейсами стоит отдавать предпочтение NVARCHAR для текстов, которые могут меняться по длине, и NCHAR для структурированных полей фиксированной длины, например, коды стран, сокращенные идентификаторы или символьные ключи. Такой подход минимизирует ошибки при хранении символов, поддерживает совместимость с внешними системами и облегчает миграцию между серверами с разными локалями.
ENUM и SET: ограниченные текстовые значения для выбора
ENUM позволяет хранить один из заранее определённых текстовых вариантов. Например, поле status может принимать только значения ‘new’, ‘in_progress’ или ‘completed’. С точки зрения базы данных, ENUM хранится как числовой индекс, что ускоряет сравнения и экономит место по сравнению с VARCHAR. При проектировании важно строго ограничивать список допустимых значений: добавление новых вариантов требует изменения структуры таблицы. ENUM оптимален для статичных списков, где количество вариантов невелико и не предполагается частая модификация.
SET используется для хранения комбинации нескольких фиксированных текстовых значений одновременно. Поле SET(‘red’,’green’,’blue’) позволяет хранить любые комбинации этих трёх цветов, например ‘red,blue’. SET тоже сохраняется как числовой битовый набор, что обеспечивает эффективное хранение и быстрые проверки наличия конкретного элемента. Ограничение SET – необходимость заранее определять все возможные значения; добавление новых элементов требует изменения структуры таблицы.
При выборе между ENUM и SET стоит учитывать назначение данных: если поле всегда содержит только один выбор – ENUM, если требуется множественный выбор – SET. Для больших списков значений и динамических изменений лучше использовать отдельную связанную таблицу с внешними ключами, так как ENUM и SET плохо масштабируются при частых модификациях.
Использование ENUM и SET повышает контроль целостности данных: база автоматически отклоняет любые значения, не включённые в список, что снижает вероятность ошибок ввода. При индексировании ENUM и SET индексы строятся по внутреннему числовому представлению, что ускоряет поиск и сортировку по этим полям.
Рекомендуется давать значениям ENUM и SET короткие, уникальные строки без пробелов и специальных символов, чтобы минимизировать вероятность ошибок и облегчить последующую обработку в SQL-запросах и приложениях.
Использование индексов на текстовых полях для ускорения поиска
Индексы на текстовых полях значительно повышают скорость выборки данных, особенно при работе с большими объемами информации. Для полей типа CHAR и VARCHAR эффективны B-деревья, обеспечивающие логарифмическое время поиска по точному совпадению и диапазонам. Для полей TEXT и CLOB рекомендуется использовать полнотекстовые индексы, позволяющие выполнять поиск по отдельным словам и фразам, а также учитывать морфологию и стоп-слова.
При проектировании индекса важно ограничивать его длину: в MySQL для VARCHAR(255) индекс обычно создают на первых 100–150 символах, что снижает нагрузку на хранение и ускоряет вставку данных. В PostgreSQL индексы типа GIN и GiST на текстовых полях обеспечивают эффективный поиск по массивам слов, а также поддерживают поиск с использованием регулярных выражений и операторов @@ для полнотекстового поиска.
Использование индексов следует сочетать с анализом выборок. Если текстовое поле редко участвует в условиях WHERE или JOIN, индекс может увеличить время вставки и обновления без практической пользы. В случаях поиска по префиксам оптимальны индексы типа BTREE, для поиска по содержимому текста – полнотекстовые или GIN-индексы. Для оптимизации запросов рекомендуется выполнять EXPLAIN-планы, чтобы оценить, используется ли индекс при конкретных запросах.
При работе с большими коллекциями текстов эффективна сегментация индекса по частям или создание составных индексов, объединяющих текстовое поле с датой или идентификатором, что ускоряет фильтрацию и ранжирование результатов. Также стоит учитывать кодировку текста: индексы на UTF-8 занимают больше памяти, чем на ASCII, что напрямую влияет на производительность.
Различия между ASCII и Unicode для текстовых полей
ASCII использует 7-битное кодирование, обеспечивая поддержку только 128 символов: латинские буквы, цифры и ограниченный набор управляющих символов. Для баз данных это означает, что поле с типом CHAR или VARCHAR, настроенное на ASCII, экономит память, но не способно хранить символы других алфавитов, акценты или специальные знаки.
Unicode поддерживает несколько схем кодирования, включая UTF-8, UTF-16 и UTF-32, что позволяет хранить символы всех мировых языков, эмодзи и специальные символы. UTF-8 использует переменную длину от 1 до 4 байт на символ, UTF-16 – 2 или 4 байта, UTF-32 – фиксированные 4 байта. Выбор кодировки напрямую влияет на размер текстового поля и производительность операций поиска и сортировки.
Для баз данных с глобальными пользователями рекомендуется использовать Unicode UTF-8, так как оно сохраняет совместимость с ASCII, минимизирует расход памяти для латинских символов и поддерживает мультибайтовые символы при необходимости. ASCII подходит только для систем с ограниченным набором символов, где гарантированно не потребуется ввод текста на других языках.
При проектировании текстовых полей стоит учитывать сортировку и сравнение. В ASCII сортировка однозначна и быстра, но не учитывает локализацию. В Unicode collation позволяет корректно сравнивать символы разных языков, но может требовать дополнительной настройки индексов и увеличивать время выполнения операций.
Резюмируя, выбор между ASCII и Unicode зависит от требуемого набора символов: ASCII эффективен по памяти для узкоспециализированных систем, Unicode обеспечивает универсальность и готовность к глобальному использованию данных.
Обработка пробелов и специальных символов в текстовых колонках
При работе с текстовыми колонками важно контролировать пробелы, особенно ведущие и завершающие. Во многих СУБД функции TRIM, LTRIM и RTRIM удаляют лишние пробелы и предотвращают ошибки при сравнении строк. Например, ‘ user ‘ и ‘user’ будут считаться разными без применения TRIM.
Внутренние пробелы также требуют внимания. Для нормализации можно использовать регулярные выражения или функции REPLACE, заменяя множественные пробелы на один. Это снижает риск некорректного поиска и сортировки, особенно при фильтрации текстов.
Специальные символы, включая переносы строки (\n), табуляции (\t) и символы Unicode, могут нарушать работу индексов и функций сравнения. Рекомендуется заранее удалять или заменять их на допустимые символы. Например, использование REPLACE для перевода табуляции в пробел предотвращает некорректное отображение и ошибки экспорта.
При хранении текстов с потенциальными HTML- или SQL-символами важно применять экранирование. В SQL это чаще всего делается через двойные апострофы для одинарных кавычек, а для HTML – через специальные сущности (<, >, &). Это предотвращает инъекции и сохраняет целостность данных.
Для Unicode-текста необходимо убедиться, что кодировка колонки соответствует типу данных, например, NVARCHAR в SQL Server или TEXT с UTF-8 в MySQL. Некорректная кодировка может приводить к отображению непонятных символов и искажению текста при обработке.
Автоматическая нормализация строк позволяет стандартизировать ввод. Функции для удаления лишних пробелов, замены специальных символов и приведения к единой кодировке обеспечивают консистентность и упрощают поиск, сортировку и сравнение текстовых данных.
Вопрос-ответ:
Какие существуют типы полей для хранения текстовой информации в базах данных?
В базах данных для хранения текстовых данных применяются несколько типов полей. Наиболее распространены CHAR и VARCHAR для коротких строк фиксированной и переменной длины соответственно, TEXT для больших объемов текста, а также специализированные типы, например, NCHAR и NVARCHAR, поддерживающие национальные наборы символов и юникод. Каждый из них имеет свои ограничения по длине и особенности хранения.
В чем разница между CHAR и VARCHAR?
CHAR предназначен для строк фиксированной длины: если задано поле CHAR(10) и вводится значение длиной 6 символов, система добавит 4 пробела до достижения полной длины. VARCHAR хранит строки переменной длины, занимая ровно столько места, сколько нужно для введенного текста, плюс небольшой служебный объем. Поэтому CHAR удобен для данных одинаковой длины, а VARCHAR позволяет экономить место при переменном размере текста.
Когда стоит использовать тип TEXT вместо VARCHAR?
TEXT применяется для хранения больших объемов текста, например, описаний, комментариев или статей, которые могут превышать несколько тысяч символов. В отличие от VARCHAR, поля TEXT часто хранятся отдельно от основной таблицы, что позволяет базе данных обрабатывать большие данные без значительного увеличения размера основной записи. Однако такие поля нельзя индексировать так же легко, как VARCHAR, поэтому их использование целесообразно именно для длинных текстов.
Что такое NCHAR и NVARCHAR и в чем их отличие от обычных CHAR и VARCHAR?
NCHAR и NVARCHAR поддерживают кодировку Юникод, что позволяет хранить символы разных языков без потери данных. NCHAR работает с фиксированной длиной, NVARCHAR — с переменной. Это особенно полезно для приложений с мультиязычным контентом, где обычные CHAR и VARCHAR могут не корректно сохранять символы с диакритикой или из других алфавитов.
Как выбор типа текстового поля влияет на производительность базы данных?
Тип поля определяет, сколько памяти будет использоваться и как быстро данные будут обрабатываться. CHAR может быть быстрее при поиске и сравнении коротких строк одинаковой длины, так как структура записи фиксирована. VARCHAR экономит место, но может потребовать больше операций при перераспределении памяти. TEXT и подобные большие поля обрабатываются медленнее и требуют отдельного хранения, поэтому их использование влияет на скорость выборки и индексацию.
Какие типы полей обычно используют для хранения текста в базах данных и чем они отличаются?
В базах данных существуют разные типы полей для текстовой информации, и их выбор зависит от объема и характера данных. Например, короткие строки обычно хранятся в полях с фиксированной или ограниченной длиной, таких как CHAR и VARCHAR. CHAR всегда занимает заданное количество символов, даже если строка короче, а VARCHAR хранит только фактическое количество символов, экономя место. Для больших текстов применяют типы TEXT или CLOB, которые позволяют хранить сотни тысяч и даже миллионы символов, но при этом операции с такими полями могут быть медленнее, чем с короткими строками. Также различают поддерживаемые кодировки и ограничения на символы, что влияет на хранение и поиск информации.
Как выбор типа текстового поля влияет на производительность и использование памяти в базе данных?
Тип поля напрямую влияет на то, сколько памяти потребуется и насколько быстро будут выполняться запросы. Поля с фиксированной длиной, такие как CHAR, занимают одинаковое пространство для каждой записи, что упрощает вычисление смещений при чтении и может ускорять доступ при больших таблицах. Поля с переменной длиной, такие как VARCHAR, используют память более рационально, особенно если строки имеют разную длину, но при этом могут требовать дополнительных операций для управления размером. Для очень больших текстов, хранящихся в типах TEXT или CLOB, данные часто сохраняются отдельно от основной таблицы, что снижает скорость выборки при стандартных запросах, но позволяет работать с объемными документами без ограничения длины.

 Загрузка...