Содержание статьи
Хэш-код строки – это числовое представление её содержимого, используемое для быстрого доступа в структурах данных. Когда две разные строки, например «Aa» и «BB» в Java, возвращают один и тот же хэш-код, возникает коллизия, которая напрямую влияет на скорость поиска и корректность работы коллекций. При высокой плотности таких совпадений операции в HashMap, Dictionary или хэш-таблицах баз данных начинают деградировать от O(1) к O(n), что заметно даже на наборах из десятков тысяч ключей.
Практическая проблема проявляется не только в снижении производительности. В веб-приложениях известны атаки, где злоумышленник подбирает тысячи строк с одинаковым хэшем и перегружает сервер, заставляя его тратить процессорное время на цепочки сравнений. Чтобы снизить риск, для строковых ключей рекомендуется использовать алгоритмы с высокой диффузией, такие как SHA-256 или MurmurHash3, а также включать случайную «соль» при генерации хэша, если ключи приходят из недоверенных источников.
При проектировании собственных хэш-функций для строк следует учитывать распределение символов и длину ключей. Простые схемы вроде суммирования кодов символов или умножения на фиксированный коэффициент дают предсказуемые коллизии. Более надёжный подход – применять побитовое смешивание и циклические сдвиги, что уменьшает вероятность совпадений даже для строк с похожими префиксами. Для проверки качества распределения полезно прогонять наборы из 100 000+ случайных строк и анализировать количество одинаковых хэшей.
Что происходит при совпадении хэш кодов у двух разных строк в словарях и множествах
Когда две разные строки попадают в одну и ту же ячейку хэш-таблицы из-за совпавшего хэш кода, словарь или множество не теряет данные, но меняет способ их хранения. Вместо одного значения в корзине создаётся цепочка или дерево элементов, где каждая запись хранит исходную строку и её значение. При последующих операциях структура вынуждена переходить от быстрого доступа по индексу к последовательным или древовидным сравнениям самих строк.
Типовая логика обработки коллизии в коллекциях выглядит так:
- по хэш коду вычисляется индекс корзины;
- в корзине перебираются все элементы с тем же хэш кодом;
- для каждого кандидата вызывается сравнение строк по содержимому;
- совпадение по строке подтверждает попадание в нужный элемент.
В Java до 8 версии каждая корзина была обычным связным списком, поэтому 1000 строк с одинаковым хэшем приводили к 1000 сравнений при поиске. Начиная с Java 8 при превышении порога в 8 элементов корзина преобразуется в красно-чёрное дерево, что снижает сложность поиска до O(log n), но всё равно уступает прямому доступу при отсутствии коллизий.
В Python словари применяют открытую адресацию: при совпадении хэша запускается линейное или псевдослучайное пробирование соседних ячеек. Это означает, что при большом количестве строк с одинаковым хэш кодом растёт длина цепочки проверок, увеличивая время операций вставки и поиска.
Для прикладных систем это даёт измеримые последствия:
- увеличение времени ответа API при работе с большими наборами ключей;
- рост потребления CPU из-за частых сравнений строк;
- падение пропускной способности при атаках на хэш-таблицы.
Чтобы снизить ущерб от коллизий, на практике используют такие меры:
- выбор хэш-алгоритмов для строк с хорошим распределением, например MurmurHash3 или SipHash;
- включение случайной соли при инициализации словаря, если ключи поступают от внешних пользователей;
- ограничение максимальной длины и набора символов строковых ключей;
- периодический мониторинг числа элементов в корзинах при нагрузочном тестировании.
Как языки программирования сравнивают строки после обнаружения совпадающего хэша
Совпадение хэш кодов используется только как фильтр первого уровня, после которого любая стандартная библиотека переходит к точному сравнению строк по их содержимому. В Java метод equals() для String сначала проверяет длину, затем последовательно сравнивает символы в кодировке UTF-16, что позволяет быстро отбросить большинство несовпадений, даже если хэши одинаковы.
В .NET строки являются неизменяемыми и могут интернироваться, поэтому после совпадения хэша среда выполнения сначала проверяет, указывают ли ссылки на один и тот же объект. Если нет, вызывается String.Equals, который выполняет побайтное сравнение символов в памяти, используя оптимизированные SIMD-инструкции на современных процессорах.
В CPython после коллизии в словаре выполняется проверка длины строк, а затем побайтное сравнение UTF-8 представлений. При больших строках это может занимать заметное время, поэтому начиная с Python 3.3 применяется случайная «соль» в хэшировании, чтобы затруднить подбор множества ключей с одинаковым хэшем.
В JavaScript движки V8 и SpiderMonkey после совпадения хэша переходят к сравнению внутренних представлений строк, которые могут быть как плоскими массивами символов, так и деревьями конкатенаций. Перед полным сравнением выполняется проверка длины и указателей на сегменты, что позволяет быстро выявлять различия без чтения всей строки.
При разработке библиотек и сервисов рекомендуется учитывать стоимость этих сравнений: длинные ключи с общими префиксами увеличивают время работы при коллизиях. Практика показывает, что для строк длиннее 64–128 символов выгодно применять хэш-алгоритмы с более равномерным распределением и избегать пользовательских схем сравнения, которые обходят встроенные оптимизации рантайма.
Примеры строк, дающих одинаковый хэш в популярных алгоритмах
В стандартной реализации Java String.hashCode() используется формула с множителем 31 и 32-битным переполнением. Классический пример коллизии – строки «Aa» и «BB»: обе дают значение 2112. Это не ошибка, а следствие линейной формулы, где разные комбинации символов могут приводить к одному и тому же остатку по модулю 2³².
Та же формула создаёт каскад совпадений для более длинных строк. Например, «AaAa» и «BBBB» также имеют одинаковый хэш, как и пары «AaBB» и «BBAa». При добавлении таких ключей в HashMap они попадают в одну корзину и требуют дополнительных сравнений строк, что легко измеряется при нагрузочном тестировании.
В алгоритме DJB2, часто используемом в C-проектах, хэш вычисляется умножением на 33 и сложением байтов. Для него известны коллизии вроде «ab» и «b@» при работе с 32-битным типом, так как переполнение стирает различия на старших разрядах. Это делает DJB2 нежелательным выбором для строк, приходящих из внешних источников.
Даже криптографические функции могут иметь опубликованные коллизии. Для MD5 существуют разные бинарные строки, дающие один и тот же 128-битный хэш, что привело к его исключению из задач проверки целостности и идентификации. Для строковых ключей в словарях это означает, что MD5 не должен использоваться как единственный критерий равенства.
Как коллизии влияют на поиск и вставку элементов в хэш-таблицах
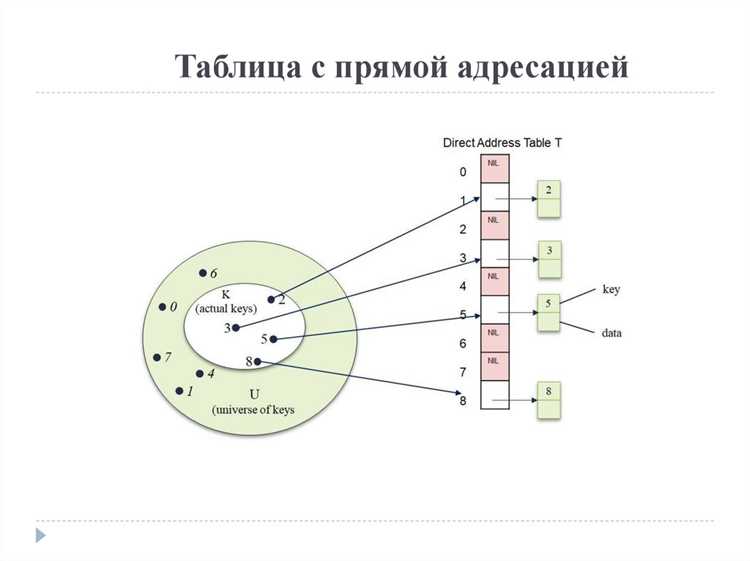
Хэш-таблица рассчитана на то, что ключи равномерно распределяются по корзинам, и тогда операции поиска и вставки требуют одной адресации и одного сравнения строки. При появлении коллизий несколько разных строк попадают в одну и ту же корзину, из-за чего каждая операция вынуждена дополнительно проверять уже сохранённые ключи, что увеличивает число обращений к памяти и количество сравнений символов.
Если в одной корзине оказывается, например, 50 строк с одинаковым хэшем, поиск нужного элемента в реализации со списком требует до 50 сравнений строк, а вставка – ещё и проверки на отсутствие дубликата. Для строк длиной 100 символов это означает до 5000 операций сравнения байтов за одну логическую операцию, что хорошо видно в профилировщиках при нагрузке.
| Состояние корзины | Поиск | Вставка |
|---|---|---|
| 1 элемент | 1 сравнение строки | 1 проверка и запись |
| 10 элементов | до 10 сравнений | до 10 сравнений + добавление |
| 100 элементов | до 100 сравнений | до 100 сравнений + добавление |
В языках с преобразованием корзин в деревья, как в Java 8+, рост сложности ограничивается O(log n), но каждый узел всё равно требует полного сравнения строк, поэтому длинные и похожие ключи продолжают создавать нагрузку на процессор и кэш памяти.
Чтобы снизить влияние коллизий на прикладные системы, рекомендуется контролировать коэффициент заполнения таблицы, увеличивать её размер до того, как средняя длина цепочек превысит 5–8 элементов, и применять хэш-функции для строк с хорошим распределением, чтобы одинаковые префиксы и шаблоны символов не концентрировались в одних и тех же корзинах.
Методы обнаружения коллизий при отладке и тестировании
Самый прямой способ выявить коллизии – логировать распределение хэш кодов по корзинам во время работы приложения. В Java и .NET это делается через обход внутренних структур словаря и подсчёт количества элементов в каждой корзине; превышение 8–10 записей в одной ячейке указывает на проблемные группы строк.
При модульном тестировании полезно генерировать десятки тысяч строк с разной длиной и набором символов и сохранять пары «строка – хэш». Повторы хэшей легко находятся сортировкой или использованием вспомогательного словаря, где ключом служит сам хэш, а значением список строк, его давших.
Для нагрузочных сценариев применяют профилировщики CPU и аллокатора памяти. Резкий рост времени, проведённого в методах сравнения строк, таких как equals в Java или String.Equals в .NET, часто напрямую указывает на массовые коллизии в хэш-таблицах.
В Python и JavaScript можно временно подменять стандартную хэш-функцию на упрощённую и наблюдать, как меняется производительность словарей при росте числа ключей. Это позволяет заранее увидеть, насколько чувствителен конкретный набор строк к совпадениям хэшей.
Для сервисов, принимающих строки от пользователей, практикуют фуззинг: автоматические генераторы создают миллионы случайных и структурированных ключей, после чего анализируется распределение хэшей и длины цепочек. Такой подход помогает обнаружить наборы строк, которые могут привести к перегрузке хэш-таблиц ещё до выхода системы в продакшн.
Приёмы уменьшения риска коллизий при проектировании хэш-функций для строк
Основа надёжной хэш-функции для строк – качественное смешивание всех байтов входных данных. Вместо простых сумм или линейных формул с одним множителем применяют каскады операций: XOR, циклические сдвиги и умножения на разные нечётные константы, как это сделано в MurmurHash3 и xxHash, где каждый символ влияет на большинство бит результата.
Для строк в кодировке UTF-8 или UTF-16 важно обрабатывать именно байтовое представление, а не коды символов по отдельности. Это снижает вероятность того, что строки с одинаковыми символами в разных языках или с общими префиксами будут давать схожие хэши.
В системах, работающих с недоверенными данными, добавляют скрытую соль – случайное 32- или 64-битное число, подмешиваемое в начальное состояние хэша. Такой приём, используемый в SipHash, делает невозможным подбор множества строк с одинаковым результатом без знания этого значения.
Длина результата также играет роль: 64-битные хэши дают 2⁶⁴ возможных значений против 2³² у стандартных 32-битных схем. Для наборов из миллионов строк это уменьшает вероятность совпадений на порядки и заметно сокращает среднюю длину цепочек в хэш-таблицах.
При собственной реализации полезно проверять функцию на больших наборах тестовых строк и строить распределение хэшей по корзинам. Если более 1–2% значений концентрируется в малой части диапазона, формулу следует дорабатывать, меняя константы и порядок операций до получения равномерного распределения.
Как выбирать хэш-алгоритм для строковых ключей в прикладных системах
Выбор хэш-алгоритма для строк напрямую влияет на скорость словарей, устойчивость к коллизиям и безопасность сервиса. Для внутренних структур с контролируемыми данными подходят быстрые некриптографические функции, а для публичных API требуется защита от намеренно подобранных наборов строк.
- для кэширования и индексации в памяти – MurmurHash3, xxHash64, CityHash;
- для сетевых сервисов и веб-фреймворков – SipHash с секретным ключом;
- для проверки целостности и подписи – SHA-256 или SHA-512, но не для словарей.
При оценке алгоритма важно учитывать длину и структуру ключей. Если строки короткие и состоят из ASCII-символов, слабые функции быстро образуют кластеры одинаковых хэшей. Для ключей длиной 50–200 символов с повторяющимися префиксами требуется алгоритм с активным смешиванием битов на каждом шаге.
- измерить распределение хэшей на реальном наборе строк;
- оценить среднюю и максимальную длину цепочек в хэш-таблице;
- проверить поведение при фуззинге с миллионами случайных ключей;
- сравнить нагрузку на CPU при равном количестве операций.
Если система обрабатывает пользовательские строки, алгоритм без секретной соли легко становится целью атак. В таких случаях применение SipHash или его аналогов снижает риск формирования больших групп коллизий и стабилизирует время ответа даже при враждебных входных данных.
Реальные сбои и уязвимости, вызванные коллизиями строковых хэшей
В 2011–2012 годах уязвимости в хэш-таблицах веб-фреймворков на PHP, Java и Python позволяли атакующим отправлять тысячи специально подобранных строк с одинаковыми хэш кодами, что приводило к резкому росту времени обработки HTTP-запросов и фактическому отказу в обслуживании. В ряде конфигураций время разбора параметров формы увеличивалось с миллисекунд до секунд при всего нескольких тысячах ключей.
В Java до внедрения деревьев в корзинах HashMap такие наборы строк вызывали линейный обход длинных списков при каждом доступе к параметрам запроса или заголовкам, что делало сервер уязвимым к дешёвым атакам с одного клиента. После Java 8 проблема была частично снята, но нагрузка на сравнение строк всё равно оставалась заметной.
В Python похожая ситуация привела к введению случайной соли в хэшировании строк в версии 3.3. Без неё атакующие могли заранее вычислить наборы ключей, формирующие большие кластеры в словарях, что отражалось на производительности фреймворков вроде Django и Flask.
Даже вне атак коллизии становились причиной сбоев в кэшах и индексах. В системах логирования и аналитики, где миллионы строковых идентификаторов попадали в хэш-таблицы, неудачный выбор функции приводил к перегрузке отдельных корзин и росту времени ответа на запросы в несколько раз.
Для предотвращения таких сценариев практикуют обязательное использование солёных хэшей для пользовательских данных, регулярное нагрузочное тестирование с враждебными наборами строк и мониторинг длины цепочек в хэш-таблицах, чтобы аномальные распределения выявлялись до того, как они приведут к отказам сервиса.
Вопрос-ответ:
Почему две разные строки могут иметь один и тот же хэш код и как часто это происходит на практике?
Хэш — это число фиксированной длины, а строк потенциально бесконечно много, поэтому совпадения неизбежны по математическим причинам. В 32-битных схемах вроде Java String.hashCode вероятность заметных совпадений начинает расти уже при сотнях тысяч ключей. При неудачном распределении символов коллизии могут появляться гораздо раньше, особенно у строк с одинаковыми шаблонами.
Может ли коллизия привести к тому, что словарь вернёт не то значение?
Стандартные реализации словарей не путают разные строки с одинаковым хэшем, потому что после совпадения числового значения выполняется сравнение самих строк. Ошибочный результат возможен только при нарушении контракта equals/hashCode или при использовании хэша как единственного признака равенства в самописных структурах.
Почему атаки через подбор строк с одинаковым хэшем так сильно нагружают сервер?
При тысячах ключей, попавших в одну корзину, каждая операция поиска или вставки вынуждена последовательно сравнивать все строки. Для длинных параметров это означает тысячи сравнений байтов на один HTTP-запрос, что быстро съедает процессорное время и снижает пропускную способность.
Есть ли смысл использовать криптографические хэши для ключей словаря?
Для обычных коллекций это избыточно из-за высокой стоимости вычислений. Криптографические функции применяют, когда ключи приходят от пользователей и требуется защита от преднамеренного подбора коллизий, но чаще выбирают более быстрые солёные алгоритмы вроде SipHash.
Как разработчику проверить, что его набор строк не создаёт проблем с коллизиями?
Берут реальный список ключей, вычисляют для него хэши выбранным алгоритмом и анализируют распределение по корзинам. Если обнаруживаются длинные цепочки, стоит сменить функцию или увеличить разрядность хэша, а также провести фуззинг со случайными и шаблонными строками.
Почему при использовании одинаковых строковых ключей в разных сервисах могут возникать разные наборы коллизий?
Разные платформы применяют разные хэш-функции и способы смешивания байтов строки. Java, Python и JavaScript используют собственные формулы и могут добавлять случайную соль, поэтому один и тот же набор строк распределяется по корзинам по-разному. Если один сервис работает без соли и с 32-битным хэшем, а другой — с 64-битным и скрытым ключом, первый может получить длинные цепочки в словарях, тогда как второй обойдётся без них при тех же входных данных.

 Загрузка...