Содержание статьи
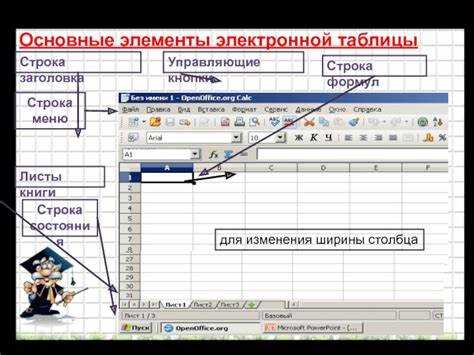
Электронные таблицы часто содержат сотни и тысячи строк, где нужные данные могут быть спрятаны среди однотипных значений, повторов и пустых ячеек. Ошибка в одном символе, лишний пробел или неверный формат числа способны полностью изменить результат поиска. Поэтому работа с данными в таблице начинается не с нажатия кнопки «Найти», а с понимания структуры диапазона, типов данных и логики их хранения.
Поиск информации в таблице – это не одна операция, а последовательность действий: от проверки формата ячеек до выбора подходящего инструмента. В одних ситуациях достаточно встроенной функции поиска, в других – требуется фильтрация строк, сортировка или применение формул для сопоставления значений между листами. Каждый метод решает свою задачу и подходит для конкретного сценария.
В этой статье рассматриваются практические шаги работы с данными: как искать текст и числа, находить связанные записи, определять положение значений и визуально выделять результаты. Акцент сделан на типичных задачах пользователей Excel и Google Sheets – от поиска одного значения до анализа больших массивов данных с повторяющимися записями.
Пошаговый подход позволяет сократить количество ошибок и ускорить работу с таблицами. Освоив базовые и продвинутые способы поиска, можно уверенно ориентироваться в данных, проверять информацию и использовать таблицу как полноценный инструмент анализа, а не просто хранилище чисел.
::contentReference[oaicite:0]{index=0}
Поиск информации в электронной таблице шаг за шагом
Поиск данных в электронной таблице начинается с уточнения задачи: требуется найти конкретное значение, группу записей или взаимосвязанные данные на разных листах. Для одиночного поиска используется встроенная функция «Найти», где важно учитывать регистр, формат ячеек и наличие скрытых символов. Например, число, сохранённое как текст, не будет найдено при стандартном поиске числовых значений.
Следующий шаг – ограничение области поиска. Работа с выделенным диапазоном позволяет избежать совпадений за пределами нужного блока данных. Это особенно актуально для таблиц с несколькими логическими разделами или служебными столбцами. Перед поиском стоит проверить, не включены ли пустые строки и объединённые ячейки, так как они искажают результаты.
Если требуется найти не одно значение, а набор записей по условиям, применяется фильтрация. Фильтры позволяют отбирать строки по тексту, числам, датам и пользовательским правилам. Например, можно оставить только заказы за определённый период или строки, содержащие фрагмент текста в названии.
Для поиска связанных данных между таблицами используются формулы сопоставления. ВПР, ГПР и ПОИСКПОЗ позволяют находить значения по ключу и возвращать связанные параметры. При этом критично, чтобы ключевые столбцы не содержали дубликатов и различий в формате данных.
Завершающий этап – проверка результатов. Условное форматирование помогает визуально выделить найденные значения, а инструменты удаления дубликатов позволяют убедиться, что данные не повторяются. Такой последовательный подход снижает риск ошибок и делает работу с таблицей управляемой даже при большом объёме информации.
::contentReference[oaicite:0]{index=0}
Подготовка диапазона данных для точного поиска
Диапазон для поиска должен представлять собой непрерывную таблицу без пустых строк и столбцов внутри массива данных. Даже одна пустая строка разрывает структуру и приводит к тому, что поиск, фильтры и формулы работают только с частью информации. Все данные, относящиеся к одной задаче, размещаются в пределах одного прямоугольного диапазона.
Заголовки столбцов играют ключевую роль. Они должны быть уникальными, краткими и располагаться строго в первой строке диапазона. Использование объединённых ячеек или многострочных заголовков затрудняет ориентацию в данных и мешает корректному выбору столбцов при поиске и фильтрации.
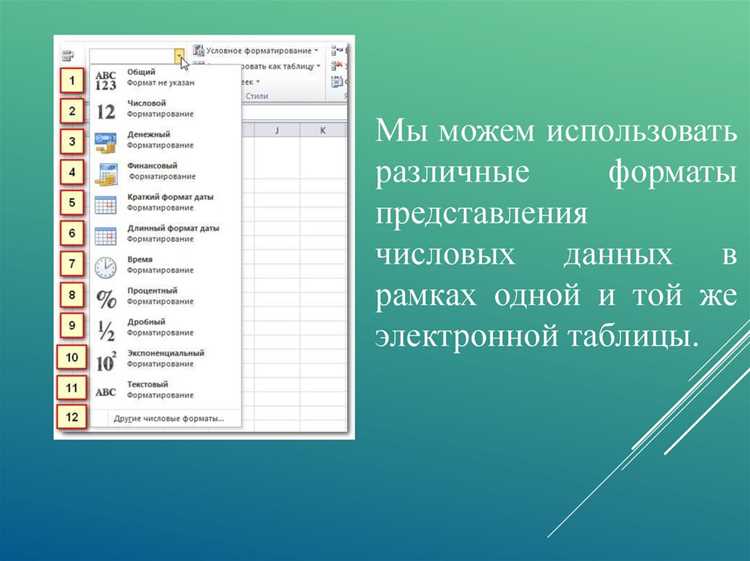
Формат данных проверяется до начала поиска. Числовые значения, даты и текст не должны смешиваться в одном столбце. Например, если часть чисел сохранена как текст, поиск по числовым условиям даст неполный результат. Проверка выполняется через параметры формата ячейки и визуальное выравнивание содержимого.
Отдельно устраняются лишние символы: пробелы, переносы строк, неотображаемые знаки. Они часто появляются при импорте данных из других систем и делают совпадения невозможными. Очистка выполняется до поиска, чтобы исключить ложные расхождения.
На финальном этапе диапазон проверяется на повторяющиеся значения в ключевых столбцах. Если поиск предполагает сопоставление данных или возврат связанных параметров, наличие дубликатов приводит к неоднозначным результатам. После удаления повторов и выравнивания структуры таблица становится готовой к точному поиску информации.
::contentReference[oaicite:0]{index=0}
Использование команды «Найти» для поиска значений и текста
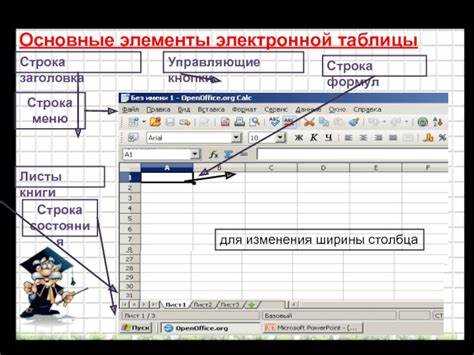
Команда «Найти» применяется для быстрого обнаружения текста, чисел и символов в пределах листа или выделенного диапазона. Перед запуском поиска рекомендуется заранее выделить область данных, чтобы исключить совпадения в служебных столбцах и примечаниях.
Окно поиска содержит параметры, которые напрямую влияют на результат. Их настройка позволяет избежать ложных совпадений и пропусков значений:
- учёт регистра – используется при поиске кодов, артикулов и идентификаторов;
- поиск по всему содержимому ячейки или по формуле – важно при работе с вычисляемыми значениями;
- поиск точного совпадения или фрагмента текста – помогает находить части слов и чисел.
Для навигации по найденным результатам применяется пошаговый просмотр. Каждое нажатие кнопки перехода перемещает курсор к следующему совпадению, что удобно при проверке данных и выявлении ошибок ввода.
При работе с числовыми значениями важно учитывать формат ячеек. Если число сохранено как текст, стандартный поиск чисел его не обнаружит. В таких случаях поиск выполняется по текстовому представлению значения или предварительно приводится формат столбца.
Команда «Найти» поддерживает расширенные сценарии использования:
- поиск специальных символов, включая знаки подстановки;
- переход ко всем найденным ячейкам через список совпадений;
- проверка формул на наличие конкретных функций или ссылок.
Грамотная настройка параметров поиска позволяет использовать команду «Найти» не только для обнаружения данных, но и для контроля структуры таблицы, проверки формул и анализа содержимого ячеек.
::contentReference[oaicite:0]{index=0}
Применение фильтров для отбора строк по заданным условиям
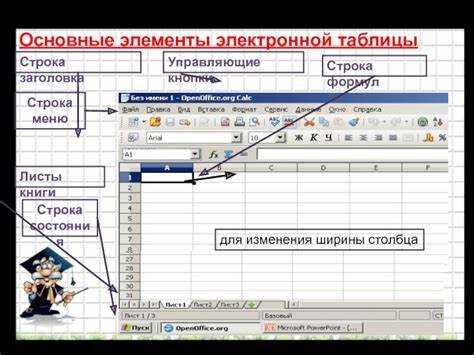
Фильтры используются для временного скрытия строк, которые не соответствуют заданным условиям. Они применяются к таблицам с заголовками столбцов и работают только в пределах непрерывного диапазона. Перед включением фильтра важно убедиться, что каждая строка содержит данные одного типа без смещений и пустых ячеек в ключевых столбцах.
Стандартные фильтры позволяют отбирать строки по значениям столбца. Пользователь может оставить только нужные элементы, сняв флажки с остальных. Такой подход удобен при работе со списками товаров, клиентов или операций, где требуется быстро сузить выборку.
- фильтрация текста по совпадению, началу или фрагменту строки;
- отбор чисел по диапазону, сравнению или заданному значению;
- выбор дат по периодам, месяцам и годам.
Для более точной выборки используются пользовательские условия. Они позволяют задать сразу несколько критериев, например, отобрать строки с суммой выше заданного значения и датой в определённом интервале. Такие условия применяются внутри одного столбца или комбинируются между несколькими столбцами.
Фильтры можно накладывать последовательно, сужая выборку шаг за шагом. Каждый активный фильтр сохраняется, пока его не сбросят вручную. Это позволяет анализировать данные в разных разрезах без изменения исходной таблицы.
- включение фильтра по заголовкам столбцов;
- настройка условий отбора для одного или нескольких столбцов;
- проверка результата и сброс фильтра при необходимости.
Использование фильтров упрощает поиск информации в больших таблицах, позволяя сосредоточиться только на строках, которые соответствуют текущей задаче.
::contentReference[oaicite:0]{index=0}
Сортировка данных для быстрого обнаружения нужных записей
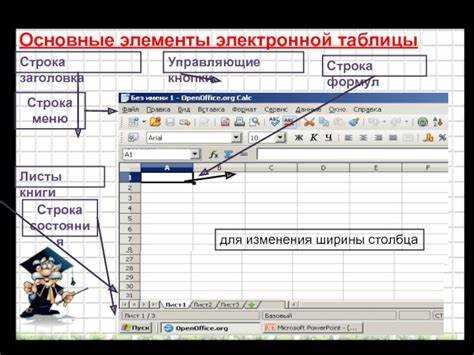
Сортировка упорядочивает строки таблицы по значениям одного или нескольких столбцов, ускоряя поиск нужных записей. Она работает только в пределах непрерывного диапазона данных с корректными заголовками столбцов. Любые пустые строки или объединённые ячейки нарушают порядок и могут смещать результаты.
Для числовых значений применяется сортировка по возрастанию или убыванию, что позволяет сразу выявлять максимальные и минимальные показатели, например, суммы заказов или количество единиц товара. Для текста используется алфавитный порядок, учитывая регистр при необходимости точного совпадения.
- Сортировка по одному столбцу – быстрый способ найти верхние или нижние значения;
- Сортировка по нескольким столбцам – полезна при комбинированной проверке, например, сначала по дате, затем по сумме;
- Сортировка по цвету или условному форматированию – визуально выделяет приоритетные записи.
Перед сортировкой рекомендуется закрепить заголовки и проверить диапазон на пустые строки и дубликаты. Это предотвращает смещение данных между строками и сохранение связей между столбцами.
Сортировка в сочетании с фильтрами позволяет быстро находить конкретные записи: сначала применяются фильтры для отбора диапазона, затем сортировка упорядочивает отобранные строки для анализа. Такой подход сокращает время поиска и повышает точность обработки данных.
::contentReference[oaicite:0]{index=0}
Поиск связанных данных с помощью формул ВПР и ГПР
Формулы ВПР (вертикальный поиск) и ГПР (горизонтальный поиск) позволяют находить связанные значения в таблицах по ключевому столбцу или строке. Они работают с диапазонами данных, где каждый ключ уникален и имеет соответствующие значения для возврата. Наличие дубликатов или пустых ячеек в ключевых столбцах приводит к некорректным результатам.
Пример использования ВПР:
| Код товара | Название | Цена |
|---|---|---|
| 101 | Ручка | 25 |
| 102 | Тетрадь | 45 |
| 103 | Карандаш | 15 |
Если требуется узнать цену по коду товара 102, формула ВПР будет выглядеть так: =ВПР(102;A2:C4;3;ЛОЖЬ). Значение «3» указывает на столбец с ценой, а «ЛОЖЬ» задаёт точное совпадение ключа.
ГПР применяется аналогично, но поиск осуществляется по строкам. Если данные расположены горизонтально, ключ находится в верхней строке, а возвращаемое значение – в строках ниже. Такой подход используется для анализа показателей по месяцам или категориям, когда ключи – это заголовки столбцов.
Для корректного поиска связанных данных:
- убедитесь, что диапазон, указанный в формуле, включает все строки или столбцы с нужными значениями;
- используйте абсолютные ссылки на диапазон, чтобы формула корректно копировалась по другим ячейкам;
- проверяйте совпадение формата ключа: текстовые коды не будут найдены в числовом формате;
- при необходимости комбинируйте ВПР и ГПР для поиска в двухмерных таблицах.
Правильное использование этих формул позволяет мгновенно связывать разрозненные данные и получать значения из больших таблиц без ручного поиска.
::contentReference[oaicite:0]{index=0}
Использование функции ПОИСКПОЗ для определения позиции значения
Функция ПОИСКПОЗ позволяет определить номер строки или столбца, где находится заданное значение в диапазоне. Она возвращает позицию относительно начала диапазона, что удобно для дальнейшего использования в формулах ВПР, ГПР или индексных вычислениях.
Синтаксис функции: =ПОИСКПОЗ(значение; диапазон; тип_сопоставления). Параметр «тип_сопоставления» определяет способ поиска:
- 0 – точное совпадение;
- 1 – наибольшее значение, меньшее или равное искомому (диапазон должен быть отсортирован по возрастанию);
- -1 – наименьшее значение, большее или равное искомому (диапазон должен быть отсортирован по убыванию).
Пример: в столбце A с кодами товаров нужно найти позицию кода 105. Формула =ПОИСКПОЗ(105;A2:A20;0) вернёт номер строки внутри диапазона, где находится этот код. Результат можно использовать в других формулах для возврата связанных данных.
Для корректного результата:
- проверяйте, чтобы диапазон не содержал пустых ячеек и дубликатов ключевых значений;
- уточняйте формат данных, чтобы текстовые и числовые значения не смешивались;
- используйте абсолютные ссылки на диапазон при копировании формулы в другие ячейки;
- комбинируйте с индексной функцией для извлечения данных по найденной позиции.
Функция ПОИСКПОЗ позволяет быстро локализовать нужные записи, автоматизировать сопоставление данных и строить динамические ссылки в больших таблицах без ручного перебора строк.
::contentReference[oaicite:0]{index=0}
Выделение найденных данных через условное форматирование
Условное форматирование позволяет визуально выделять значения, соответствующие заданным условиям, без изменения исходных данных. Оно применяется к диапазону ячеек, где необходимо быстро идентифицировать совпадения, превышения пороговых значений или особые категории данных.
Для настройки выделения конкретного значения в Excel или Google Sheets используется правило «Форматировать ячейки, если…». Например, чтобы подсветить все заказы с суммой больше 5000, выбирается диапазон с суммами и задаётся условие «больше 5000», а также форматирование – цвет фона или шрифта.
- Подсветка текста – позволяет выделить строки с определёнными словами, кодами или идентификаторами;
- Подсветка чисел – помогает быстро обнаружить максимальные, минимальные или превышающие заданный порог значения;
- Использование формул – расширяет возможности, например, =ПОИСК(«Ручка»;A2:A100)>0 выделяет все ячейки, содержащие слово «Ручка».
Для больших таблиц рекомендуется закреплять диапазон и применять условное форматирование к конкретным столбцам, чтобы не перегружать визуализацию. Если необходимо подсветить несколько условий одновременно, создаются отдельные правила с приоритетом их применения.
Условное форматирование помогает быстро анализировать данные, находить совпадения и отклонения, упрощая контроль и визуальный поиск информации без использования дополнительных формул или фильтров.
::contentReference[oaicite:0]{index=0}
Проверка и устранение дубликатов при поиске информации
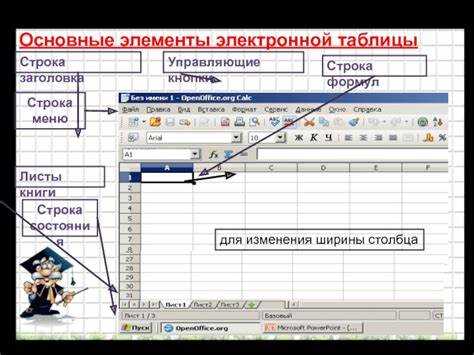
Дубликаты в таблицах искажают результаты поиска и анализа. Их наличие особенно критично при использовании формул ВПР, ПОИСКПОЗ и фильтров, так как они возвращают первое найденное совпадение, игнорируя остальные. Поэтому перед поиском рекомендуется проверить диапазон на повторяющиеся значения в ключевых столбцах.
Для обнаружения дубликатов используются встроенные инструменты таблиц. В Excel или Google Sheets можно выделить диапазон и выбрать Удалить дубликаты или создать условное форматирование для визуального выявления повторов. При этом важно определить, какие столбцы считать ключевыми для проверки – чаще всего это идентификаторы, коды или уникальные комбинации полей.
Если необходимо сохранить все записи, но отметить повторы, используется условное форматирование по формуле, например, =СЧЁТЕСЛИ($A$2:$A$100;A2)>1. Это выделяет все повторяющиеся ячейки, позволяя анализировать их вручную или фильтровать.
После выявления дубликатов можно:
- удалить их полностью для очистки данных;
- объединить информацию из повторяющихся строк, сохранив уникальные значения;
- оставить первый экземпляр и удалить последующие.
Регулярная проверка на дубликаты обеспечивает точность поиска, корректное сопоставление данных и предотвращает ошибки при работе с большими таблицами.
::contentReference[oaicite:0]{index=0}
Вопрос-ответ:
Как быстро найти нужное значение в большом столбце с числами и текстом?
Для поиска используйте команду «Найти». Убедитесь, что формат ячеек соответствует типу данных: числа должны быть числовыми, текст — текстовым. В окне поиска включите опцию точного совпадения, если требуется найти конкретное значение, и отключите поиск по формуле, если ячейки содержат вычисляемые значения. Для больших диапазонов лучше выделить столбец перед поиском, чтобы исключить случайные совпадения в соседних областях.
Можно ли одновременно выделить все совпадения определённого слова в таблице?
Да, это делается через условное форматирование. Выберите диапазон, задайте правило «Форматировать ячейки, если» с условием поиска текста. Например, формула =ПОИСК(«Ручка»;A2:A100)>0 подсветит все ячейки, содержащие слово «Ручка». Цвет фона или шрифта можно настроить, чтобы быстро увидеть все совпадения в таблице.
Как проверить таблицу на дубликаты и удалить лишние строки?
Выделите диапазон с ключевыми столбцами, затем используйте встроенную функцию «Удалить дубликаты». Если нужно сохранить все записи и только отметить повторы, примените условное форматирование по формуле =СЧЁТЕСЛИ($A$2:$A$100;A2)>1. После выявления повторов можно удалить лишние строки вручную или автоматически, оставляя первый экземпляр, чтобы сохранить структуру таблицы и корректно использовать формулы поиска.
В чём разница между ВПР и ГПР при поиске связанных данных?
ВПР ищет значения вертикально по столбцу и возвращает данные из выбранного столбца диапазона. ГПР работает горизонтально по строке и возвращает значение из выбранной строки. Использование зависит от расположения данных: если ключи находятся в столбцах, применяют ВПР, если в строках — ГПР. Для таблиц с большим количеством пересекающихся категорий можно комбинировать обе функции, чтобы получить нужное значение по координатам строки и столбца.
Как определить номер строки с нужным значением для последующих формул?
Для этого используют функцию ПОИСКПОЗ. Она возвращает позицию значения внутри указанного диапазона. Например, =ПОИСКПОЗ(105;A2:A20;0) покажет номер строки, где находится код 105. Если диапазон содержит пустые ячейки или дубликаты ключа, результат может быть неверным. После нахождения позиции её можно использовать в индексных формулах, чтобы получить связанные данные из других столбцов.

 Загрузка...