Содержание статьи
Kafka Connect – это компонент экосистемы Apache Kafka, предназначенный для потоковой передачи данных между Kafka и внешними системами без написания прикладного кода. Он используется для интеграции баз данных, хранилищ файлов, очередей сообщений, поисковых движков и облачных сервисов через стандартный API коннекторов. Вместо разработки собственных продюсеров и консьюмеров, инженер описывает конфигурацию, после чего Kafka Connect берет на себя загрузку, доставку и отслеживание состояния данных.
Основная идея Kafka Connect заключается в декларативной интеграции: источник или приемник данных описывается набором параметров, а выполнение распределяется между воркерами. Каждый коннектор разбивается на задачи, которые параллельно обрабатывают данные, сохраняя оффсеты и состояние в специальных служебных топиках Kafka. Это позволяет перезапускать процессы без потери прогресса и масштабировать обработку за счет добавления узлов.
На практике Kafka Connect применяют для сценариев CDC (Change Data Capture) из PostgreSQL, MySQL и Oracle, выгрузки событий в Elasticsearch или S3, синхронизации Kafka с очередями вроде RabbitMQ, а также передачи данных в аналитические платформы. Для промышленного использования рекомендуется запуск в распределенном режиме, настройка репликации служебных топиков и контроль совместимости версий коннекторов с брокерами Kafka.
Понимание устройства Kafka Connect важно не только для настройки коннекторов, но и для диагностики сбоев, управления нагрузкой и планирования масштабирования. Ошибки конфигурации, неправильный выбор режима запуска или некорректная стратегия партиционирования могут привести к дублированию данных или остановке задач, поэтому знание принципов работы является практической необходимостью.
Зачем нужен Kafka Connect при интеграции Kafka с внешними системами
Kafka Connect используется для стандартизации обмена данными между Kafka и внешними системами, когда потоковая интеграция должна быть устойчивой к сбоям и управляемой на уровне конфигураций. Вместо отдельных сервисов для каждой интеграции применяется единый runtime, который отвечает за подключение источников и приемников данных, распределение нагрузки и контроль состояния выполнения.
При прямой разработке продюсеров и консьюмеров инженеру приходится самостоятельно решать задачи повторной доставки, хранения оффсетов, параллельной обработки и восстановления после перезапуска. Kafka Connect берет эти функции на себя: оффсеты, конфигурации и статусы задач хранятся в служебных топиках Kafka, что позволяет безопасно перезапускать воркеры без ручного вмешательства и потери позиции в потоке.
Для интеграции с реляционными базами данных Kafka Connect предоставляет готовые коннекторы с поддержкой инкрементальной загрузки и CDC. Это снижает риск перегрузки источника, так как чтение выполняется по транзакционным логам или временным меткам, а не полным сканированием таблиц. Для систем-приемников, таких как Elasticsearch, S3 или HDFS, коннекторы обеспечивают пакетную запись, контроль формата данных и обработку ошибок доставки.
Kafka Connect упрощает масштабирование интеграций за счет автоматического распределения задач между воркерами. При увеличении объема данных достаточно добавить новый узел в кластер, после чего задачи перераспределяются без остановки коннекторов. Это особенно важно для долгоживущих потоков, где ручное управление процессами приводит к простоям и дублированию данных.
Использование Kafka Connect целесообразно в средах, где требуется прозрачное администрирование интеграций: централизованное управление конфигурациями через REST API, единый формат логирования и возможность мониторинга состояния задач. Такой подход снижает сложность сопровождения и позволяет сосредоточиться на обработке данных в Kafka, а не на поддержке связующего кода.
Архитектура Kafka Connect: воркеры, задачи и их роли
Kafka Connect построен вокруг процесса worker, который запускается как отдельное JVM-приложение и подключается к кластеру Kafka. Воркер отвечает за загрузку плагинов коннекторов, прием конфигураций через REST API, выполнение задач и взаимодействие со служебными топиками. В распределенном режиме несколько воркеров образуют кластер, внутри которого происходит автоматическое распределение нагрузки.
Каждый коннектор при запуске разбивается на одну или несколько task, количество которых определяется логикой коннектора и параметром конфигурации. Задача является минимальной единицей исполнения: именно она читает данные из источника или записывает их во внешнюю систему. Например, Source-коннектор базы данных может создавать отдельную задачу на группу таблиц или партиций.
Воркер не обрабатывает данные напрямую, его роль – управление жизненным циклом задач. Он следит за их запуском, остановкой, перераспределением и перезапуском при сбоях. При выходе воркера из строя его задачи автоматически назначаются другим участникам кластера на основе группового протокола Kafka, без ручного вмешательства администратора.
Для координации работы используются служебные топики Kafka: один хранит конфигурации коннекторов, второй – оффсеты задач, третий – их статусы. Это позволяет всем воркерам видеть актуальное состояние системы и гарантирует согласованность при масштабировании или обновлении конфигураций. Репликация этих топиков должна быть включена для защиты от потери состояния.
Практическая рекомендация при проектировании архитектуры – запускать Kafka Connect в распределенном режиме даже для небольших нагрузок, если важна отказоустойчивость. Количество задач следует подбирать с учетом числа партиций топиков Kafka и пропускной способности внешних систем, чтобы избежать узких мест и неравномерного распределения нагрузки между воркерами.
Как работают Source Connectors для загрузки данных в Kafka
Source Connectors предназначены для чтения данных из внешних систем и публикации их в топики Kafka в виде потоков записей. Каждый Source-коннектор запускается внутри воркера Kafka Connect и создает набор задач, которые параллельно опрашивают источник. Формат данных преобразуется в объекты SourceRecord, содержащие ключ, значение, схему и метаданные источника.
Ключевым элементом работы Source Connectors является управление смещениями. Вместо стандартных оффсетов Kafka используется собственный механизм, где каждая задача сохраняет позицию чтения в служебном топике. Для баз данных это может быть идентификатор транзакции, временная метка или позиция в журнале изменений. Такой подход позволяет продолжать загрузку с корректного места после перезапуска или сбоя.
Перед записью в Kafka данные проходят через цепочку преобразований Single Message Transforms. Они применяются на уровне коннектора и позволяют изменять структуру сообщений: переименовывать поля, добавлять метаданные, фильтровать события или переназначать топики. Использование SMT снижает потребность в дополнительной обработке на стороне продюсеров.
Source Connectors публикуют данные в Kafka через встроенный продюсер, соблюдая настройки надежности доставки. Рекомендуется явно задавать параметры подтверждений и ретраев, особенно при работе с источниками, где повторное чтение может приводить к дублированию данных. Для упорядочивания сообщений важно корректно настроить ключи, чтобы записи одного логического объекта попадали в одну партицию.
При выборе и настройке Source Connector следует учитывать характер источника. Для реляционных баз предпочтительны коннекторы с поддержкой CDC, так как они минимизируют нагрузку и задержки. Для файловых и API-источников важно контролировать частоту опроса и размер пакетов, чтобы избежать переполнения памяти задач и нестабильной работы воркеров.
Как работают Sink Connectors для выгрузки данных из Kafka
Sink Connectors предназначены для чтения данных из топиков Kafka и их записи во внешние системы: базы данных, поисковые индексы, файловые и объектные хранилища, HTTP-сервисы. Коннектор подписывается на один или несколько топиков, после чего задачи начинают потреблять сообщения как обычные консьюмеры Kafka, соблюдая групповую координацию и партиционирование.
Каждая задача Sink Connector получает записи в виде SinkRecord, которые содержат ключ, значение, схему и смещение Kafka. После успешной записи данных во внешнюю систему задача фиксирует оффсет в служебном топике Kafka Connect. Это гарантирует, что при перезапуске данные не будут пропущены, а повторная обработка возможна только в пределах подтверждённых смещений.
Перед передачей данных во внешнюю систему Sink Connectors могут применять Single Message Transforms для адаптации формата. Это используется для маппинга полей в структуру таблиц, формирования документов для поисковых движков или изменения ключей для корректного апдейта записей. Такие преобразования выполняются синхронно внутри задачи и влияют на пропускную способность.
Запись во внешние системы обычно выполняется пакетами. Размер батча и частота коммитов настраиваются через конфигурацию коннектора и напрямую влияют на нагрузку и задержки. Слишком крупные пакеты увеличивают время восстановления при сбоях, а слишком мелкие приводят к избыточному числу операций записи.
| Аспект | Практическое значение |
|---|---|
| Управление оффсетами | Фиксация смещений только после успешной записи во внешнюю систему |
| Пакетная запись | Снижение количества операций и контроль нагрузки |
| Ключи сообщений | Определяют обновление или вставку данных в системе-приемнике |
При эксплуатации Sink Connectors рекомендуется учитывать ограничения целевой системы. Для баз данных важно настраивать идемпотентную запись и контроль конфликтов ключей, для файловых хранилищ – ротацию и размер файлов, для HTTP-приемников – таймауты и политику повторных запросов. Эти параметры определяют стабильность выгрузки при пиковых нагрузках.
Режимы Standalone и Distributed: когда и какой выбирать
Kafka Connect поддерживает два режима запуска, которые принципиально отличаются по архитектуре и области применения. Standalone представляет собой одиночный процесс, где воркер, коннекторы и задачи работают в рамках одной JVM. Конфигурации задаются в локальных файлах, а управление жизненным циклом выполняется вручную через перезапуск процесса.
Standalone целесообразен для тестирования, прототипов и простых интеграций с предсказуемой нагрузкой. Он подходит для одноразовых или временных потоков данных, где потеря состояния при сбое не критична. При остановке процесса задачи не перераспределяются, а восстановление требует ручного запуска, что ограничивает использование в производственных средах.
Distributed режим предназначен для постоянных потоков данных и эксплуатации в кластере. Несколько воркеров образуют группу, используют REST API для управления и хранят конфигурации, оффсеты и статусы в Kafka. При отказе одного воркера его задачи автоматически переносятся на другие узлы, сохраняя прогресс обработки.
Выбор Distributed оправдан при необходимости горизонтального масштабирования, обновления конфигураций без остановки и централизованного администрирования. Добавление нового воркера приводит к перераспределению задач, что позволяет адаптироваться к росту объема данных без изменения логики коннекторов.
Практическая рекомендация заключается в использовании Standalone только для локальной разработки и отладки. Во всех сценариях, где данные имеют ценность, а интеграция должна переживать сбои и перезапуски, следует выбирать Distributed режим с реплицированными служебными топиками и выделенными ресурсами для воркеров.
Хранение конфигураций, оффсетов и статусов в Kafka
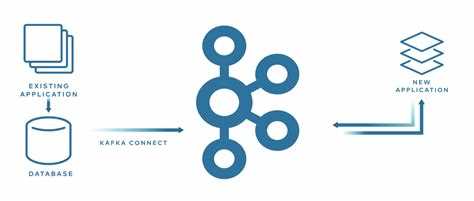
В распределенном режиме Kafka Connect использует сам Kafka как хранилище состояния, что устраняет зависимость от локальных файлов и позволяет воркерам разделять актуальную информацию. Для этого создаются специальные служебные топики, имена и параметры которых задаются в конфигурации воркера.
Каждый тип данных хранится отдельно и выполняет свою роль в управлении жизненным циклом коннекторов:
- топик конфигураций содержит параметры коннекторов и задач, передаваемые через REST API;
- топик оффсетов хранит позиции чтения для Source и Sink задач;
- топик статусов фиксирует текущее состояние коннекторов и задач, включая ошибки и остановки.
Топик конфигураций используется всеми воркерами для синхронизации. При изменении параметров коннектора новая конфигурация публикуется в Kafka и автоматически подхватывается кластером без перезапуска. Это позволяет обновлять настройки источников и приемников данных в рабочем режиме.
Оффсеты в Kafka Connect не совпадают с потребительскими оффсетами Kafka. Они представляют собой сериализованные структуры, специфичные для коннектора, и могут включать номера транзакций, идентификаторы файлов или временные метки. Фиксация оффсетов происходит только после успешной обработки данных, что снижает риск пропусков.
Топик статусов используется для мониторинга и диагностики. Он позволяет определить, какие задачи работают, остановлены или завершились с ошибкой. При проектировании кластера рекомендуется:
- задавать фактор репликации не ниже трех для всех служебных топиков;
- выделять отдельные политики хранения, чтобы статусы не удалялись раньше анализа инцидентов;
- ограничивать доступ к этим топикам через ACL, так как они содержат критичные данные о конфигурации.
Корректная настройка служебных топиков напрямую влияет на стабильность Kafka Connect. Потеря или повреждение этих данных приводит к невозможности восстановления задач, поэтому их параметры должны рассматриваться как часть базовой инфраструктуры Kafka.
Типовой жизненный цикл коннектора: от настройки до остановки
Жизненный цикл коннектора начинается с подготовки конфигурации, в которой указываются класс коннектора, параметры подключения к внешней системе, список топиков и настройки задач. В распределенном режиме конфигурация отправляется через REST API и сохраняется в служебном топике Kafka, после чего становится доступной всем воркерам кластера.
После регистрации коннектора Kafka Connect выполняет валидацию параметров и инициализацию плагина. Если конфигурация корректна, создаются задачи в количестве, определяемом настройками и возможностями коннектора. Каждая задача получает собственный контекст выполнения и назначается конкретному воркеру.
На этапе работы задачи начинают обработку данных: Source задачи читают данные из источников и публикуют их в Kafka, Sink задачи потребляют сообщения из топиков и передают их во внешние системы. В процессе фиксируются оффсеты, а состояние задач регулярно обновляется в топике статусов, что позволяет отслеживать прогресс и ошибки.
Изменение конфигурации коннектора приводит к его переразвертыванию. Kafka Connect останавливает текущие задачи, применяет новые параметры и запускает их заново, сохраняя согласованность состояния. Для обновлений рекомендуется изменять конфигурацию постепенно, чтобы избежать резких скачков нагрузки.
Остановка коннектора может быть временной или окончательной. При остановке задачи завершают обработку текущих данных и фиксируют последние оффсеты. Это позволяет при повторном запуске продолжить работу с корректной позиции. Полное удаление коннектора удаляет его конфигурацию и статусы, но не затрагивает данные в пользовательских топиках Kafka.
Для стабильной эксплуатации важно регулярно контролировать жизненный цикл коннекторов: проверять статус задач, анализировать логи воркеров и планировать перезапуски в периоды низкой нагрузки. Такой подход снижает риск незапланированных остановок и потери данных.
Вопрос-ответ:
Можно ли использовать Kafka Connect вместо собственных продюсеров и консьюмеров?
Да, если задача сводится к передаче данных между Kafka и внешними системами без сложной бизнес-логики. Kafka Connect берет на себя чтение, запись, хранение оффсетов и восстановление после перезапусков. Если требуется агрегация, корреляция событий или нестандартная обработка, тогда понадобится отдельное приложение поверх Kafka.
Что произойдет с данными, если воркер Kafka Connect неожиданно остановится?
Задачи, выполнявшиеся на этом воркере, будут переназначены другим воркерам кластера. Позиции чтения берутся из служебного топика оффсетов, поэтому обработка продолжается с последнего зафиксированного состояния. Потеря данных возможна только при некорректной настройке подтверждения записи во внешнюю систему.
Чем оффсеты Kafka Connect отличаются от оффсетов обычных консьюмеров?
Kafka Connect хранит оффсеты в собственном формате и отдельном топике. Эти значения отражают состояние источника или приемника, а не номер сообщения в партиции. Например, это может быть позиция в binlog базы данных или имя файла и смещение внутри него.
Подходит ли Kafka Connect для высокой нагрузки и больших объемов данных?
Да, при корректной настройке. Масштабирование достигается увеличением числа задач и воркеров. Следует учитывать пропускную способность внешних систем, параметры пакетной записи и количество партиций топиков Kafka, иначе часть задач будет простаивать или перегружаться.
Как обновлять конфигурацию коннектора без остановки всего кластера?
В распределенном режиме конфигурация изменяется через REST API. Kafka Connect сохранит новые параметры в служебном топике, остановит текущие задачи конкретного коннектора и запустит их заново с обновленными настройками. Остальные коннекторы и воркеры продолжат работу без перерыва.
Можно ли запускать несколько Source и Sink коннекторов в одном кластере Kafka Connect?
Да, кластер Kafka Connect рассчитан на одновременную работу большого числа коннекторов разных типов. Каждый коннектор разбивается на задачи, которые распределяются между воркерами независимо друг от друга. Ограничением выступают ресурсы узлов и пропускная способность Kafka и внешних систем. На практике для стабильной работы разделяют тяжелые коннекторы по разным кластерам или выделяют отдельные группы воркеров.
Что делать, если Sink Connector повторно записывает одни и те же данные?
Такое поведение обычно связано с повторной обработкой сообщений после сбоя или перезапуска задачи. Для снижения дублирования следует настраивать идемпотентную запись во внешнюю систему и корректные ключи сообщений. Также нужно проверить, что оффсеты фиксируются только после успешной записи, а параметры ретраев и таймаутов соответствуют возможностям системы-приемника.

 Загрузка...