Содержание статьи
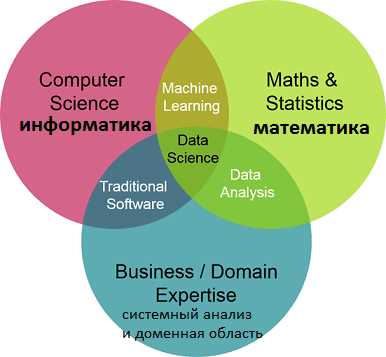
Data Science – это междисциплинарная область, которая занимается извлечением полезных знаний из данных. Современный Data Scientist использует методы статистики, машинного обучения и аналитики для того, чтобы извлечь смысл из больших объемов данных, часто неструктурированных, и на основе этого создавать модели, предсказания и рекомендации. Объем данных, с которыми работают специалисты, ежегодно увеличивается в геометрической прогрессии. По оценкам специалистов, до 2025 года мировой объем данных достигнет 175 зеттабайт, что в 10 раз больше, чем в 2016 году.
Одним из основных направлений работы Data Science является использование алгоритмов машинного обучения для создания предсказательных моделей. Эти модели могут анализировать прошлые данные и прогнозировать будущие события, что является важным инструментом в различных областях – от финансов и медицины до маркетинга и промышленности. В некоторых случаях алгоритмы помогают не только предсказывать тренды, но и оптимизировать процессы, например, улучшать качество обслуживания клиентов или повышать эффективность цепочек поставок.
Ключевым элементом работы в области Data Science является способность работать с неструктурированными данными, такими как текст, изображения или звуковые записи. Использование методов обработки естественного языка (NLP), компьютерного зрения и анализа речи позволяет извлекать информацию из данных, которые ранее было сложно или невозможно анализировать традиционными методами. В этой области активно развиваются технологии, позволяющие автоматизировать обработку и анализ этих данных.
Как Data Science помогает принимать бизнес-решения на основе данных
Data Science помогает бизнесам принимать обоснованные решения, опираясь на анализ данных, что существенно повышает точность прогнозов и эффективность операций. С помощью статистических методов и алгоритмов машинного обучения компании могут анализировать огромные объемы информации и выявлять скрытые закономерности, которые сложно заметить вручную. Например, в ритейле анализ покупательских данных позволяет предсказать спрос на товары, оптимизировать складские запасы и снизить издержки на логистику.
Один из наиболее эффективных способов применения Data Science в бизнесе – это построение предсказательных моделей. Прогнозирование спроса на продукцию, выявление потенциальных рисков или определение наиболее прибыльных сегментов рынка позволяют принимать более точные и своевременные решения. Например, для e-commerce платформ прогнозирование покупательских предпочтений на основе анализа предыдущих покупок может повысить конверсии и снизить количество возвратов товаров.
Также Data Science активно используется для персонализации взаимодействия с клиентами. Алгоритмы машинного обучения обрабатывают поведение пользователей, их предпочтения и взаимодействие с продуктом, что помогает создавать персонализированные предложения. В свою очередь, это увеличивает лояльность клиентов и повышает средний чек. В маркетинговых кампаниях на основе аналитики данных могут быть точечно настроены рекламные объявления, направленные на конкретные сегменты аудитории, что значительно повышает их эффективность.
В области финансов Data Science позволяет снизить риски и повысить безопасность. Анализ транзакций и поведенческих данных помогает выявлять мошеннические действия в реальном времени, а кредитные скоринговые модели дают возможность точнее оценить платежеспособность клиентов. Компании, использующие такие решения, могут минимизировать финансовые потери и принимать более обоснованные решения по предоставлению кредитов.
Одним из ключевых аспектов внедрения Data Science в бизнес-процессы является автоматизация принятия решений на основе анализа данных. Системы, работающие на основе машинного обучения, могут самостоятельно адаптироваться и оптимизировать процессы. Это позволяет существенно сократить время, затрачиваемое на принятие решений, и улучшить реакцию бизнеса на изменения рынка. Например, в сфере производства оптимизация планирования производства с использованием аналитики данных может снизить количество брака и повысить общую эффективность производственных линий.
Какие инструменты и технологии используют специалисты по Data Science
Для работы с большими данными (Big Data) специалисты часто используют Apache Hadoop и Apache Spark. Hadoop позволяет распределенно обрабатывать большие объемы данных, а Spark – выполнять более быстрые вычисления в памяти, что делает его подходящим для анализа данных в реальном времени. В комбинации с инструментами хранения данных, такими как HDFS (Hadoop Distributed File System) или Amazon S3, эти технологии позволяют обрабатывать данные на масштабируемых системах.
Для работы с неструктурированными данными, такими как текст, изображения или аудио, активно используются методы обработки естественного языка (NLP) и компьютерного зрения. В этой области популярны библиотеки, такие как NLTK и spaCy для NLP, а также OpenCV и Pillow для обработки изображений. Для более сложных задач, таких как обучение нейронных сетей, часто используется PyTorch и Keras.
Для анализа и визуализации данных специалисты также активно применяют Tableau, Power BI и QlikView. Эти инструменты позволяют быстро создавать интерактивные отчеты и дашборды, что помогает в принятии решений на основе данных. Важной частью аналитической работы является возможность представлять данные в виде, понятном для бизнес-анализа, и эти платформы предлагают удобные инструменты для такого рода визуализации.
Кроме того, для работы с базами данных специалисты по Data Science используют SQL для запросов к реляционным базам данных и NoSQL базы данных, такие как MongoDB или Cassandra, для обработки данных, которые не укладываются в структуру таблиц. Важно отметить, что работа с такими системами требует не только знаний теории баз данных, но и практических навыков оптимизации запросов для обеспечения высокой производительности.
Как Data Science используется для анализа больших данных
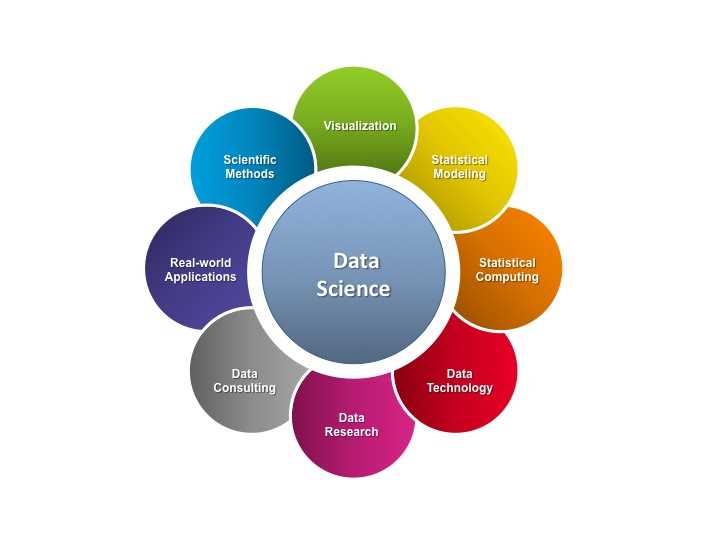
Анализ больших данных (Big Data) – одна из ключевых задач Data Science, требующая специфических инструментов и подходов. Большие данные представляют собой объемы информации, которые невозможно обработать традиционными методами, и для этого используются специализированные технологии. Применение методов Data Science к большим данным позволяет извлекать полезные инсайты, которые способствуют улучшению бизнес-процессов, повышению эффективности и прогнозированию тенденций.
Для обработки больших данных широко используются распределенные вычислительные платформы, такие как Apache Hadoop и Apache Spark. Эти системы позволяют эффективно распределять вычисления и хранение данных на кластерах серверов. Hadoop использует модель MapReduce, которая разбивает задачу на части, параллельно обрабатывает данные и затем собирает результаты. Spark, в отличие от Hadoop, работает в памяти, что значительно ускоряет обработку и подходит для аналитики в реальном времени.
Для хранения больших данных часто используются распределенные файловые системы, такие как HDFS (Hadoop Distributed File System) и облачные решения, например, Amazon S3. Эти системы позволяют масштабировать хранилище данных и обеспечивать их доступность, что особенно важно при работе с огромными объемами информации, которые могут исчисляться терабайтами и даже петабайтами.
Методы машинного обучения и статистического анализа помогают обрабатывать и анализировать данные, выявляя закономерности и строя предсказательные модели. Например, алгоритмы кластеризации могут быть использованы для сегментации клиентов в маркетинге, а регрессионные модели – для прогнозирования потребительского спроса. В сочетании с обработкой данных в реальном времени это позволяет оперативно адаптироваться к изменениям на рынке.
Для анализа больших данных специалисты активно применяют такие библиотеки, как Pandas и NumPy, которые облегчают работу с данными, их очистку и подготовку. Эти инструменты позволяют выполнять сложные вычисления и преобразования на больших объемах информации. Кроме того, использование TensorFlow и PyTorch помогает в создании нейронных сетей для решения более сложных задач, таких как распознавание образов или анализ текста.
Особое внимание уделяется аналитике в реальном времени. Использование платформ, таких как Apache Kafka, позволяет собирать и обрабатывать данные с различных источников в режиме реального времени. Это особенно важно для таких сфер, как финансовые технологии, здравоохранение или интернет вещей (IoT), где требуется быстрое реагирование на изменения в данных для предотвращения рисков или оптимизации процессов.
Какие навыки и знания необходимы для работы в Data Science
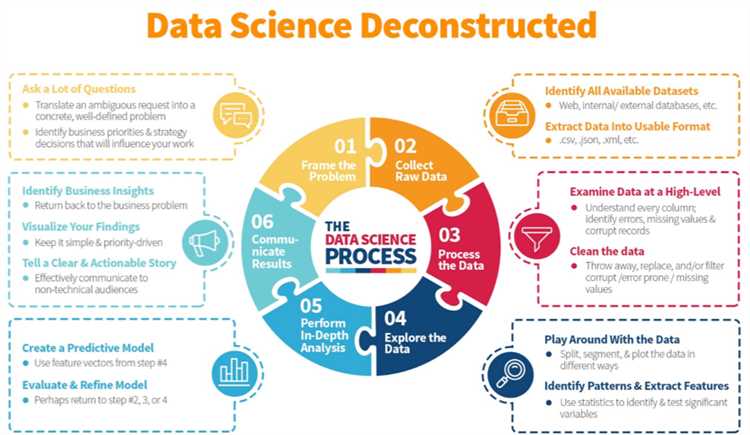
Знание статистики и теории вероятностей – обязательное условие для успешной работы в Data Science. Специалисты должны разбираться в таких понятиях, как распределения вероятностей, регрессия, гипотезы и методы статистического тестирования. Эти навыки необходимы для правильной интерпретации данных и построения моделей, которые могут давать обоснованные прогнозы. Опыт работы с методами машинного обучения, такими как классификация, кластеризация и регрессия, также является необходимым для разработки предсказательных моделей и оптимизации процессов.
Для работы с большими данными важно иметь представление о распределенных вычислениях и технологиях, таких как Apache Hadoop и Apache Spark. Знание принципов работы с этими системами позволяет эффективно обрабатывать и анализировать данные, которые не помещаются в память одного компьютера. Опыт работы с базами данных, включая реляционные (SQL) и нереляционные (NoSQL), также необходим для хранения и извлечения данных из различных источников.
Не менее важным является умение работать с данными, включая их очистку и подготовку. Нередко данные, с которыми приходится работать, содержат ошибки или отсутствующие значения. Специалисты должны уметь очищать данные с помощью инструментов, таких как Pandas в Python, и преобразовывать их в нужный формат для дальнейшего анализа. Хорошее понимание методов обработки данных, таких как нормализация, стандартизация и кодирование, значительно ускоряет процесс подготовки данных для анализа.
Наконец, умение работать в команде и коммуницировать результаты анализа является важным навыком. Data Scientist должен уметь не только разрабатывать модели, но и четко объяснять их работу коллегам из других областей бизнеса. Это требует навыков презентации и умения адаптировать информацию для разных аудиторий.
Как Data Science помогает в предсказательной аналитике
Предсказательная аналитика использует данные для прогнозирования будущих событий, что играет важную роль в принятии решений в различных отраслях. В Data Science для этого активно применяются методы машинного обучения и статистического анализа, которые позволяют строить модели на основе исторических данных и предсказывать возможные исходы. Вот несколько примеров, как это работает на практике:
- Прогнозирование спроса. Для бизнеса, особенно в ритейле, предсказание спроса на товары позволяет оптимизировать запасы и избежать недостатка или избыточных товаров. Алгоритмы машинного обучения, такие как временные ряды и регрессионные модели, анализируют сезонные колебания, тренды и изменения потребительских предпочтений.
- Оценка риска. В банковской сфере модели предсказательной аналитики помогают оценивать кредитные риски, анализируя поведение заемщиков, историю платежей и социально-экономические факторы. Это позволяет принимать более обоснованные решения о предоставлении кредитов.
- Предсказание отказов оборудования. В промышленности предсказательная аналитика используется для мониторинга состояния оборудования. Алгоритмы машинного обучения, анализируя данные с датчиков и системы мониторинга, могут предсказать поломку устройства до того, как она произойдет, что помогает минимизировать простой и снизить затраты на ремонт.
- Персонализация маркетинга. В маркетинге анализ данных о поведении клиентов позволяет предсказывать, какие товары или услуги они с наибольшей вероятностью купят. Это помогает направлять рекламные кампании на нужную аудиторию и повысить конверсии.
Основным инструментом для построения предсказательных моделей являются алгоритмы машинного обучения. Наиболее часто используемые модели включают:
- Регрессионные модели. Эти модели помогают предсказывать числовые значения, например, стоимость товара или доход компании, на основе факторов, таких как исторические данные и текущие условия.
- Классификационные модели. Они позволяют прогнозировать категории, к которым относится объект. Например, в здравоохранении классификация пациентов по степени риска заболевания.
- Методы кластеризации. Эти алгоритмы используются для группировки данных на основе сходства, например, для сегментации клиентов или определения аномальных паттернов в данных.
Применяя эти методы в различных сферах, Data Science помогает точнее и быстрее принимать решения, что снижает риски и увеличивает прибыль. Важно, что для создания качественных предсказаний необходимо не только иметь хорошие данные, но и использовать правильные методы их обработки и анализа. Эффективность предсказательной аналитики зависит от качества данных, их объема и способности моделей учитывать различные факторы, влияющие на результат.
Что такое машинное обучение и как оно связано с Data Science
В Data Science машинное обучение играет ключевую роль, так как помогает обрабатывать большие объемы данных и делать точные прогнозы. Использование этих технологий позволяет Data Scientist создавать модели, которые предсказывают будущее, классифицируют объекты, ищут аномалии и выявляют скрытые зависимости. Применение машинного обучения в Data Science расширяет возможности аналитиков и позволяет решать более сложные задачи, такие как:
- Прогнозирование. Например, алгоритмы машинного обучения предсказывают покупательский спрос, ценовые тренды или вероятные риски. Это особенно важно в таких отраслях, как финансы и ритейл.
- Классификация данных. Используется для сортировки объектов в категории, например, для идентификации заболеваний у пациентов или классификации электронной почты на спам и не спам.
- Обнаружение аномалий. Машинное обучение помогает выявлять необычные паттерны в данных, что может быть полезно для обнаружения мошенничества в банковских транзакциях или в промышленности – для выявления дефектов на производстве.
В процессе работы специалисты по Data Science используют различные типы машинного обучения:
- Обучение с учителем. В этом подходе модель обучается на размеченных данных, то есть с заранее заданными метками. Например, в задаче классификации животных алгоритм обучается на наборе данных с изображениями животных и их метками (птица, кошка, собака).
- Обучение без учителя. Этот метод используется, когда метки для данных отсутствуют. Алгоритм ищет скрытые структуры в данных, например, группирует пользователей на основе их покупок в интернет-магазине.
- Обучение с подкреплением. Этот тип обучения основан на принципе проб и ошибок. Алгоритм получает вознаграждение за правильные действия и штраф за ошибки, что позволяет ему оптимизировать свою работу.
Машинное обучение тесно связано с Data Science, так как предоставляет инструменты для создания моделей, которые могут обрабатывать и анализировать большие объемы данных. Вместе с методами статистического анализа, визуализации данных и работы с большими данными, машинное обучение позволяет Data Scientist делать точные прогнозы и принимать обоснованные решения, основанные на данных. В сочетании с другими методами, такими как обработка естественного языка или компьютерное зрение, машинное обучение значительно расширяет возможности аналитики и бизнес-решений.
Как обеспечить качество и достоверность данных для анализа в Data Science
1. Очистка данных. Первым шагом является удаление или исправление ошибок в данных. Часто данные могут содержать пропущенные значения, дубликаты, неверные или аномальные записи. Важно применить методы очистки, такие как:
- Удаление дубликатов. Необходимо выявлять и удалять повторяющиеся записи, чтобы не исказить результаты анализа.
- Заполнение пропусков. Пропущенные значения можно заполнить с использованием статистических методов, таких как среднее, медианное значение, или более сложных алгоритмов, например, имперсонации.
- Исправление ошибок. Для числовых данных можно использовать методы проверки на выбросы и замену значений, которые сильно отклоняются от нормальных диапазонов.
2. Валидация данных. Для повышения достоверности данных необходимо проводить валидацию источников. Проверка точности и актуальности данных важна для подтверждения их надежности. Это может включать использование официальных баз данных, перепроверку данных через несколько независимых источников или использование алгоритмов, которые помогут обнаружить аномалии в данных.
3. Стандартизация и нормализация. Когда данные поступают из разных источников, они могут быть представлены в разных форматах. Для корректного анализа важно привести их к единому виду. Например, все даты должны быть в одном формате, числовые данные – иметь одинаковые единицы измерения, а текстовые поля – быть очищены от лишних пробелов и знаков. Стандартизация помогает улучшить сопоставимость данных, что важно для машинного обучения и статистического анализа.
4. Обработка категориальных данных. Для работы с категориальными данными важно правильно их кодировать. Алгоритмы машинного обучения часто требуют, чтобы текстовые данные были преобразованы в числовые. Применяются методы one-hot encoding, label encoding и другие подходы, которые позволяют сохранить значимость категориальных признаков без потери информации.
5. Мониторинг качества данных. Данные, особенно в реальном времени, могут меняться или устаревать. Поэтому для сохранения их достоверности важно регулярно проверять и обновлять данные. Это может включать настройку автоматических систем мониторинга, которые отслеживают актуальность данных и уведомляют о возможных проблемах.
6. Визуализация и анализ данных. Важным этапом обеспечения качества данных является их визуализация. Используя графики и диаграммы, можно выявить закономерности и аномалии, которые могут указывать на проблемы с данными. Например, использование коробочных диаграмм позволяет обнаружить выбросы, а корреляционные тепловые карты – проверить взаимосвязь между различными переменными.
Вопрос-ответ:
Что такое Data Science и чем он отличается от обычной аналитики данных?
Data Science — это более широкая область, чем традиционная аналитика данных. В отличие от классической аналитики, которая обычно фокусируется на описании данных и создании отчетов, Data Science включает в себя использование машинного обучения, статистических методов и алгоритмов для построения моделей, которые могут прогнозировать будущее или находить скрытые закономерности в данных. Data Science помогает не просто анализировать данные, но и принимать на их основе обоснованные решения и строить предсказания.
Какие навыки и знания нужны для того, чтобы стать специалистом в области Data Science?
Для работы в области Data Science важно иметь прочные знания в программировании (особенно на Python или R), статистике и математике. Нужно быть уверенным в использовании библиотек для анализа данных, таких как Pandas и NumPy, а также для построения моделей машинного обучения (например, Scikit-learn, TensorFlow или PyTorch). Знания работы с большими данными (Hadoop, Spark) и умение работать с базами данных (SQL и NoSQL) также являются необходимыми. Плюсом будет умение визуализировать данные и представлять результаты с помощью инструментов, как Tableau или Power BI.
Как Data Science помогает бизнесу принимать решения на основе данных?
Data Science помогает бизнесу, анализируя данные, выявлять важные паттерны, которые могут влиять на процесс принятия решений. Например, с помощью предсказательной аналитики можно прогнозировать поведение клиентов, что помогает компаниям корректировать маркетинговые стратегии, оптимизировать запасы товаров и повышать лояльность клиентов. Модели машинного обучения могут предложить способы улучшения операционных процессов, снижения рисков и увеличения прибыли, а также дать рекомендации по ценовым стратегиям.
Что такое машинное обучение, и как оно связано с Data Science?
Машинное обучение — это один из основных методов, используемых в Data Science для анализа данных. Это подмножество искусственного интеллекта, которое позволяет моделям учиться на данных и делать прогнозы без явного программирования каждого шага. В Data Science машинное обучение используется для создания предсказательных моделей, например, для классификации, регрессии или кластеризации данных. Без машинного обучения анализ данных был бы ограничен простыми статистическими методами, в то время как современные задачи требуют сложных моделей для обработки больших и неструктурированных данных.
Как обеспечить качество и достоверность данных для работы в Data Science?
Для того чтобы данные, на основе которых строится анализ, были качественными, необходимо пройти несколько этапов: сначала их очищают от ошибок, пропусков и дубликатов. Также важно валидировать данные, проверяя их на корректность и актуальность. Часто приходится стандартизировать данные, чтобы привести их в единый формат. Например, даты должны быть в одном формате, а числовые значения — в одинаковых единицах измерения. Важно постоянно мониторить данные и обновлять их, чтобы они не устарели. Работа с такими методами, как нормализация и кодирование категориальных переменных, помогает подготовить данные для дальнейшего анализа.
Как Data Science используется для улучшения бизнес-решений?
Data Science позволяет компаниям использовать данные для принятия более обоснованных и точных решений. Применяя аналитические методы и машинное обучение, бизнес может не только понимать текущие тенденции, но и прогнозировать будущее. Например, в ритейле аналитика данных помогает предсказать, какой товар будет востребован в ближайшее время, что позволяет оптимизировать запасы и снизить издержки. В маркетинге Data Science помогает персонализировать рекламные предложения, ориентируясь на поведение пользователей, что повышает конверсию. В финансовом секторе Data Science применяется для оценки рисков и прогнозирования возможных убытков. Такой подход позволяет не только реагировать на текущие изменения, но и заранее адаптировать бизнес-процессы для будущих потребностей.

 Загрузка...