Содержание статьи
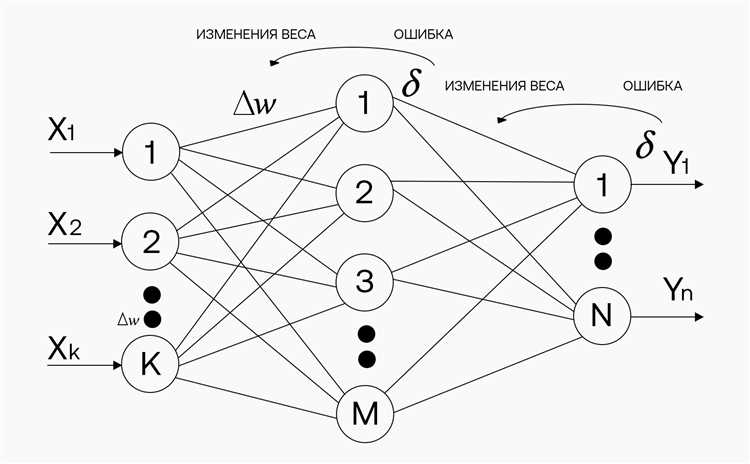
Loss функция задаёт числовое представление ошибки модели и напрямую определяет, какие параметры будут обновляться в процессе обучения. Любая нейронная сеть оптимизирует не «качество в целом», а строго конкретную формулу, вычисляемую для каждого батча данных. Например, при использовании Mean Squared Error модель наказывает крупные отклонения квадратично, тогда как Mean Absolute Error изменяет веса линейно, что приводит к принципиально разной динамике обучения и распределению ошибок.
Неправильный выбор loss функции часто приводит к парадоксальным результатам: модель демонстрирует снижение значения функции потерь, но при этом ухудшает бизнес-метрики или пользовательские показатели. Типичный пример – бинарная классификация с сильным дисбалансом классов, где стандартная Binary Cross-Entropy смещает обучение в сторону доминирующего класса, игнорируя редкие, но критичные случаи. В таких сценариях приходится вводить взвешивание классов или модифицировать формулу ошибки.
Loss функция также определяет форму ландшафта оптимизации. Гладкость, наличие плато, резкие скачки градиентов – всё это следствие математических свойств выбранной функции. Использование Hinge Loss приводит к разреженным градиентам, а Log-Cosh сглаживает влияние выбросов без жёсткого отсечения. Эти различия становятся особенно заметны при обучении глубоких сетей с большим числом параметров.
На практике loss функцию редко используют в «чистом» виде. Её дополняют регуляризационными слагаемыми, штрафами за нарушение ограничений или доменными правилами. В задачах компьютерного зрения добавляют структурные компоненты, в рекомендационных системах – штрафы за популярность, в временных рядах – асимметричные ошибки для разных направлений прогноза. Понимание роли loss функции позволяет осознанно управлять обучением модели, а не полагаться на значения по умолчанию.
Что измеряет loss функция и как она формализует ошибку предсказаний
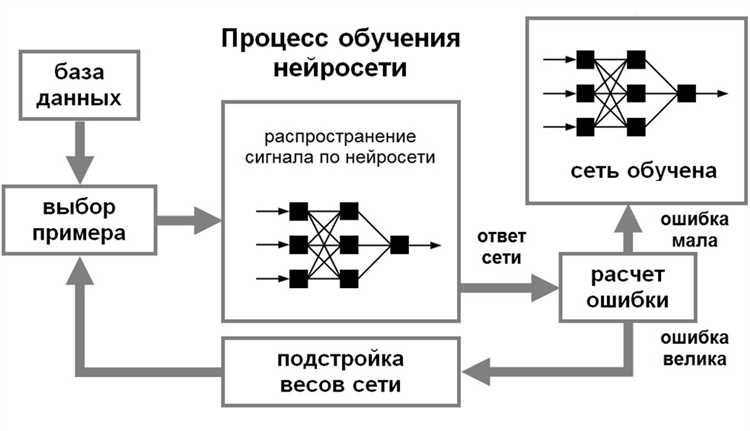
Loss функция переводит расхождение между предсказанием модели и истинным значением в скалярную величину, пригодную для оптимизации. Она не измеряет «точность» в интуитивном смысле, а фиксирует конкретный тип ошибки, заданный математической формулой. Например, при регрессии с Mean Squared Error ошибка определяется как среднее квадрата разности между прогнозом и целевым значением, из-за чего отклонения в 2 раза больше наказываются в 4 раза сильнее.
Формализация ошибки всегда отражает допущения о данных. Mean Absolute Error предполагает линейную цену ошибки и устойчивость к выбросам, тогда как Huber Loss комбинирует линейный и квадратичный режимы, ограничивая влияние аномальных значений после заданного порога. Выбор конкретной формулы означает выбор того, какие ошибки считаются допустимыми, а какие – критичными.
В задачах классификации loss функция оценивает не сам класс, а распределение вероятностей. Cross-Entropy измеряет расхождение между истинным распределением и предсказанным, штрафуя модель за избыточную уверенность в неверном классе. Предсказание с вероятностью 0.01 для правильного класса даёт на порядок больший вклад в loss, чем вероятность 0.3, даже если оба варианта приводят к одинаковой ошибке классификации.
Loss функция агрегируется по всем объектам обучающей выборки, формируя глобальный критерий оптимизации. При этом каждая отдельная ошибка влияет на градиенты и, следовательно, на обновление весов. Если формула ошибки асимметрична, модель будет смещать предсказания в сторону меньшего штрафа, что особенно важно в задачах прогнозирования, где переоценка и недооценка имеют разную стоимость.
На практике рекомендуется проверять, соответствует ли интерпретация ошибки реальной задаче. Если целевая метрика зависит от ранжирования, порогов или бизнес-штрафов, стандартная loss функция может формализовать неправильный сигнал обучения. В таких случаях используют кастомные функции потерь, которые напрямую кодируют нужный тип ошибки, а не абстрактное отклонение от целевого значения.
Как выбор loss функции зависит от типа задачи: регрессия, классификация, сегментация
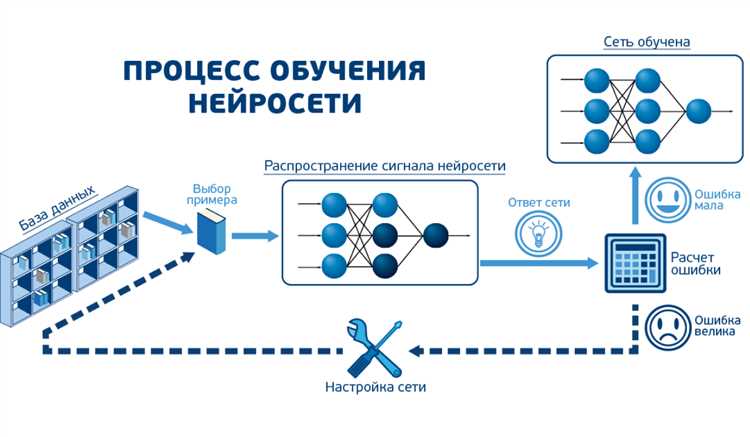
В задачах регрессии loss функция определяет, как модель реагирует на величину числовой ошибки. Mean Squared Error усиливает вклад крупных отклонений и подходит, когда редкие большие ошибки недопустимы, например при прогнозе нагрузки или финансовых показателей. Mean Absolute Error предпочтительнее при наличии выбросов, так как каждый промах влияет линейно. Если данные содержат шум с редкими аномалиями, практичным выбором становится Huber Loss с заранее заданным порогом.
Для классификации ключевым фактором является работа с вероятностями. Cross-Entropy оптимизирует распределение предсказаний и резко штрафует модель за уверенные ошибки. В бинарных задачах с перекосом классов стандартная формула приводит к игнорированию редкого класса, поэтому используют взвешенную Binary Cross-Entropy или добавляют коэффициенты к положительным примерам. В многоклассовых сценариях Softmax Cross-Entropy позволяет учитывать относительную уверенность между всеми классами.
Сегментация объединяет свойства регрессии и классификации, так как ошибка считается на уровне каждого пикселя или вокселя. При сильном дисбалансе фона и целевых областей классическая Pixel-wise Cross-Entropy смещает обучение в сторону фона. В таких случаях применяют Dice Loss или IoU Loss, которые оптимизируют перекрытие предсказанных и истинных масок, а не количество правильно классифицированных пикселей.
Комбинирование функций потерь часто даёт более управляемый сигнал обучения. Для сегментации используют сумму Cross-Entropy и Dice Loss, где первая стабилизирует обучение на ранних этапах, а вторая усиливает внимание к границам объектов. В регрессии добавляют регуляризационные слагаемые, а в классификации – margin-based компоненты, если важна уверенность разделения классов.
Практическая рекомендация заключается в согласовании loss функции с конечной метрикой задачи. Если модель оценивается по MAE, но обучается на MSE, она будет смещать предсказания. Для сегментации медицинских изображений оптимизация точности пикселей редко коррелирует с качеством контуров, поэтому выбор функции потерь должен отражать именно тот аспект ошибки, который критичен для применения.
Как loss функция влияет на градиенты и скорость сходимости при обучении
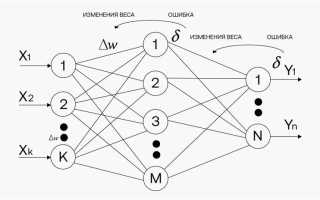
Форма loss функции напрямую определяет величину и распределение градиентов, которые передаются через сеть при обратном распространении ошибки. Квадратичные функции, такие как Mean Squared Error, увеличивают градиент пропорционально величине отклонения, из-за чего крупные ошибки доминируют в обновлении весов. Это ускоряет исправление грубых промахов, но повышает риск нестабильных шагов оптимизации на ранних итерациях.
Линейные и кусочно-линейные функции потерь формируют более равномерные градиенты. Mean Absolute Error генерирует постоянный модуль градиента, что замедляет корректировку крупных ошибок, но делает обучение предсказуемым. В глубоких сетях это снижает вероятность резких скачков весов, однако может приводить к длительным плато, особенно при малых значениях learning rate.
В задачах классификации Cross-Entropy в сочетании с softmax или sigmoid создаёт градиенты, зависящие от уверенности предсказания. Ошибочные и уверенные прогнозы дают наибольший вклад в обновление параметров, тогда как почти правильные предсказания быстро теряют влияние. Это ускоряет сходимость на начальных этапах, но при насыщении активаций градиенты могут стремиться к нулю.
Негладкие участки loss функции напрямую отражаются на динамике оптимизации. Кусочные функции, такие как Hinge Loss, приводят к обнулению градиентов для корректно классифицированных примеров, что сокращает вычисления, но снижает плотность обучающего сигнала. Сглаженные аналоги уменьшают количество «мёртвых» областей, поддерживая обновление весов даже при близких к правильным предсказаниях.
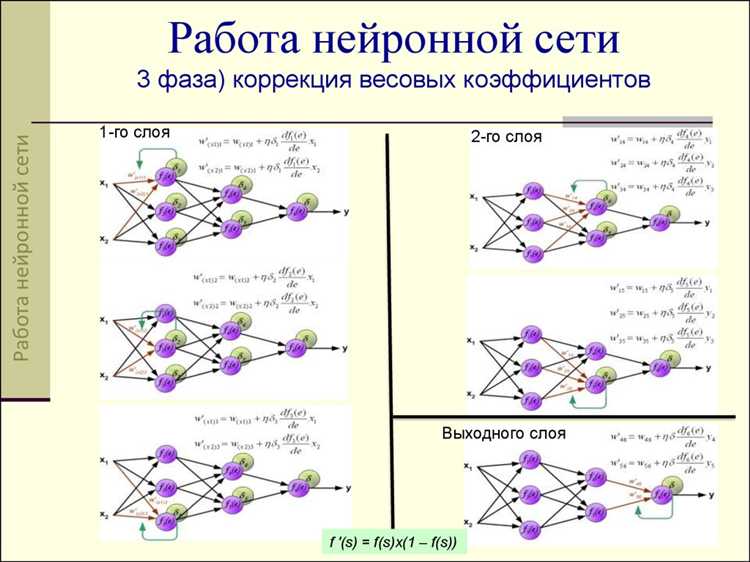
На практике скорость сходимости зависит не только от оптимизатора, но и от масштаба градиентов, задаваемого loss функцией. Рекомендуется проверять распределение значений loss и норм градиентов на первых эпохах обучения. Если наблюдаются взрывающиеся градиенты или длительное отсутствие прогресса, целесообразно заменить функцию потерь на более сглаженную или изменить её масштаб с помощью нормализации и коэффициентов.
Чем отличаются популярные loss функции и в каких сценариях их применяют
Mean Squared Error и Mean Absolute Error различаются не только формулой, но и поведением модели. MSE резко увеличивает вклад крупных ошибок и подходит для задач, где редкие промахи имеют высокую цену, например при прогнозе энергопотребления или спроса. MAE сохраняет одинаковый вес всех отклонений и используется, когда распределение ошибок содержит выбросы и важна устойчивость к аномальным значениям.
Huber Loss сочетает линейный и квадратичный режимы, что делает её удобной для регрессии с шумными данными. При малых ошибках она ведёт себя как MSE, обеспечивая точную подстройку, а при превышении порога переходит в линейный режим, ограничивая влияние выбросов. Значение порога следует подбирать по распределению целевой переменной, а не оставлять параметр по умолчанию.
В классификации доминирует Cross-Entropy, так как она работает с вероятностными предсказаниями и напрямую связана с максимизацией правдоподобия. Для бинарных задач используют sigmoid-вариант, для многоклассовых – softmax. При дисбалансе классов добавляют веса или заменяют стандартную формулу на Focal Loss, которая снижает вклад легко классифицируемых примеров и усиливает влияние сложных случаев.
Для задач сегментации и обнаружения объектов применяются функции, ориентированные на геометрию предсказаний. Dice Loss и IoU Loss измеряют степень перекрытия масок и менее чувствительны к доминированию фона. Их используют, когда количество положительных пикселей существенно меньше отрицательных, что типично для медицинских и спутниковых изображений.
Выбор loss функции должен учитывать не только тип задачи, но и свойства данных. Если целевая переменная имеет тяжёлые хвосты распределения, предпочтение стоит отдавать устойчивым функциям. При работе с вероятностями важно избегать функций, не согласованных с выходными активациями. Практика показывает, что замена стандартной функции потерь на специализированную часто даёт больший прирост качества, чем усложнение архитектуры модели.
Как несоответствие loss функции и метрики качества искажает обучение модели
Loss функция задаёт направление обновления весов, тогда как метрика качества используется для оценки результата. Если эти два критерия оптимизируют разные свойства предсказаний, модель начинает улучшать одно, ухудшая другое. Типичный пример – регрессия, где обучение ведётся по Mean Squared Error, а оценка проводится по Mean Absolute Error. В этом случае модель систематически смещает прогнозы в сторону сглаживания экстремальных значений, что снижает MAE при стабильных данных, но ухудшает его при асимметричных распределениях.
В классификации несоответствие проявляется ещё жёстче. Оптимизация Cross-Entropy ориентирована на калибровку вероятностей, тогда как метрики вроде accuracy или F1-score зависят от выбранного порога. Модель может снижать loss, повышая уверенность в уже правильно классифицированных объектах, не улучшая количество верных решений после порогового преобразования. В результате обучение продолжается без роста целевой метрики.
Особенно критична эта проблема при дисбалансе классов. Обучение по стандартной Binary Cross-Entropy минимизирует среднюю ошибку, но метрики recall или precision для редкого класса могут деградировать. Модель снижает loss за счёт доминирующего класса, игнорируя те примеры, которые определяют практическую ценность решения. Без взвешивания loss функции или её модификации рост итоговой метрики становится маловероятным.
В задачах сегментации оптимизация по пиксельной точности и оценка по IoU или Dice приводят к систематическому смещению в сторону фона. Loss уменьшается за счёт корректного предсказания большинства пикселей, но перекрытие объектов остаётся низким. Это создаёт иллюзию прогресса на этапе обучения при отсутствии улучшений на валидации.
Практическая рекомендация заключается в максимальном сближении loss функции и целевой метрики. Если метрика недифференцируема, следует использовать её дифференцируемые приближения или комбинировать несколько функций потерь. Дополнительно полезно отслеживать корреляцию между значением loss и основной метрикой на валидационных данных: её отсутствие указывает на фундаментальное несоответствие критериев оптимизации.
Как настраивать и модифицировать loss функцию под данные и бизнес-ограничения
Настройка loss функции позволяет модели учитывать особенности данных и приоритеты бизнеса. Стандартная функция потерь часто не отражает важность редких событий, асимметрию ошибок или критические сценарии. Для корректной настройки применяют несколько подходов:
- Взвешивание классов. В задачах с дисбалансом добавляют коэффициенты к редким классам, например в Weighted Cross-Entropy, чтобы увеличить вклад значимых примеров и предотвратить игнорирование важных данных.
- Комбинирование функций потерь. Суммируют или взвешивают несколько функций, например Cross-Entropy + Dice Loss для сегментации, где первая стабилизирует обучение, а вторая усиливает внимание к объектам малого размера.
- Асимметричные штрафы. Для бизнес-сценариев с разной стоимостью ошибок применяют модификации loss функции, которые сильнее наказывают недооценку или переоценку прогноза. Пример: регрессия с экономической стоимостью недопоставки или перепроизводства.
- Регуляризация через loss. Добавляют слагаемые, которые учитывают желаемые свойства модели: ограничение нормы весов, устойчивость к шуму, соблюдение ограничений на выходные значения.
- Дифференцируемые аппроксимации метрик. Если бизнес-метрика недифференцируема (например, F1-score или IoU), используют её дифференцируемое приближение в loss функции, чтобы обучение напрямую приближало ключевой показатель качества.
Для практической настройки рекомендуется:
- Проанализировать распределение данных и выявить редкие или критические случаи.
- Согласовать loss функцию с ключевыми бизнес-метриками.
- Проверять распределение градиентов на первых эпохах, чтобы избежать взрывающихся или слишком малых обновлений.
- Тестировать несколько комбинаций функций потерь и коэффициентов на валидационном наборе, ориентируясь на метрики, отражающие реальные бизнес-цели.
Корректная модификация loss функции позволяет модели фокусироваться на критичных для бизнеса ошибках, ускоряет сходимость на значимых данных и повышает практическую ценность предсказаний без необходимости усложнять архитектуру сети.
Вопрос-ответ:
Почему разные задачи требуют разных loss функций и как это влияет на обучение модели?
Каждая задача формулирует ошибку по-своему. В регрессии важна величина числового отклонения, поэтому применяют Mean Squared Error или Mean Absolute Error, чтобы контролировать чувствительность к выбросам. В классификации основной сигнал идёт через вероятности, и для этого используют Cross-Entropy, которая корректирует веса в зависимости от уверенности модели. Если выбрать неподходящую функцию, градиенты будут направлены не туда, где это реально улучшает прогноз, и обучение может привести к предсказаниям с низкой ценностью для конкретной задачи.
Как несоответствие loss функции и метрики качества влияет на итоговый результат модели?
Если loss функция оптимизирует один критерий, а оценка проводится по другому, модель начинает улучшать не те аспекты предсказаний, которые имеют практическую значимость. Например, при обучении регрессии по Mean Squared Error, но проверке по Mean Absolute Error модель может уменьшать крупные ошибки за счёт смещения средних значений, но не сокращать среднюю абсолютную погрешность. В классификации это проявляется, когда снижение loss не приводит к росту accuracy или F1-score из-за несоответствия между вероятностями и порогами классификации.
Как выбор loss функции влияет на градиенты и скорость сходимости нейронной сети?
Форма функции потерь определяет амплитуду градиентов и их распределение по сети. Квадратичные функции усиливают влияние крупных ошибок, ускоряя исправление сильных промахов, но могут вызывать нестабильные обновления весов. Линейные функции дают равномерный сигнал и более предсказуемое обучение, но скорость сходимости снижается. В классификации Cross-Entropy создаёт большие градиенты для уверенно ошибочных предсказаний, ускоряя исправление ключевых ошибок на ранних этапах, тогда как почти правильные прогнозы почти не влияют на обновления.
Когда имеет смысл модифицировать стандартную loss функцию под бизнес-ограничения?
Модификация оправдана, если стандартная формула не учитывает реальные последствия ошибок. Например, в прогнозировании спроса недопоставка может быть более критичной, чем перепроизводство. В таких случаях добавляют асимметричные штрафы, чтобы смещать градиенты в сторону защиты от дорогих ошибок. В задачах сегментации с малым объектом используют комбинацию Cross-Entropy и Dice Loss, чтобы сеть не игнорировала редкие, но важные пиксели. Такие настройки позволяют направить обучение на то, что реально важно для приложения модели.
Как проверить, что выбранная loss функция подходит для данных и задачи?
Первый шаг — анализ распределения ошибок на небольших тестовых данных. Если loss чувствителен к выбросам, а данные содержат шум, градиенты могут быть нестабильными. Следующий шаг — проверка корреляции между loss и ключевой метрикой на валидации. Если снижение loss не сопровождается улучшением метрики, функция потерь не соответствует цели. Можно тестировать модифицированные или комбинированные функции и наблюдать, как изменяется метрика на выборке, отражающей реальные условия применения модели.
Как правильно комбинировать несколько loss функций, чтобы улучшить обучение модели для сложной задачи сегментации?
Комбинирование функций потерь используется для того, чтобы сеть одновременно учитывала разные аспекты ошибки. Например, в сегментации изображений часто применяют сочетание Cross-Entropy и Dice Loss. Cross-Entropy даёт стабильный градиент на ранних этапах обучения, обеспечивая корректное разделение классов, а Dice Loss усиливает внимание к объектам малого размера и перекрытию предсказанных и истинных масок. Для настройки комбинации вводят коэффициенты, которые задают относительный вклад каждой функции: слишком большой вес Dice Loss на начальном этапе может вызвать нестабильные градиенты, а слишком малый — не даст исправить ошибки с редкими пикселями. Практическая стратегия — тестировать несколько вариантов весов на валидационном наборе, анализируя не только снижение суммарного loss, но и ключевые метрики качества, например IoU или точность объектов. Такой подход позволяет направить обучение на критичные для задачи ошибки, сохранив стабильность оптимизации.

 Загрузка...