Содержание статьи
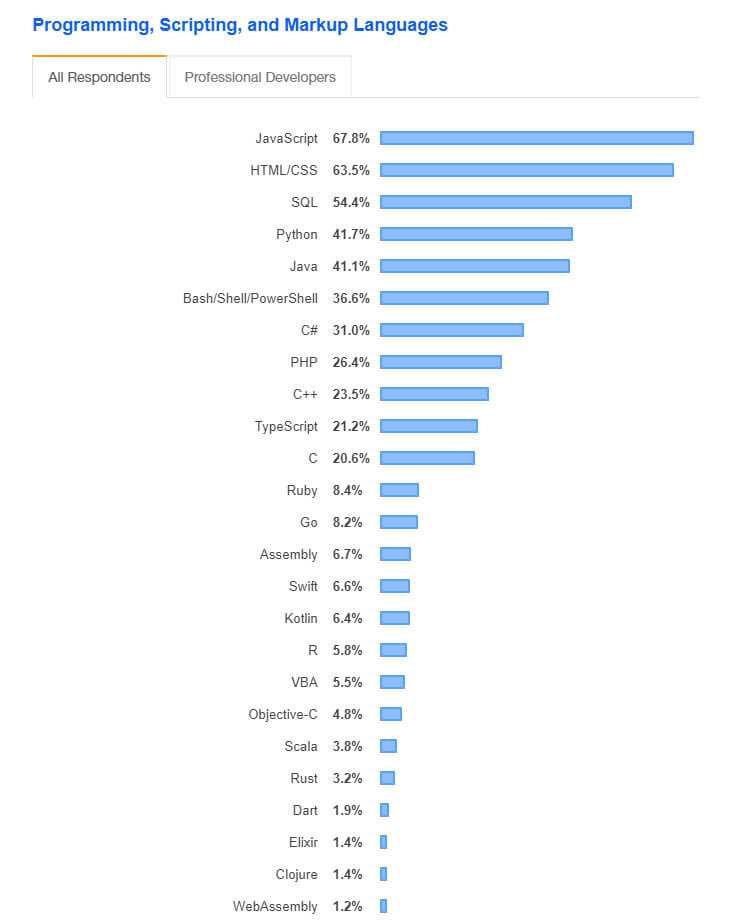
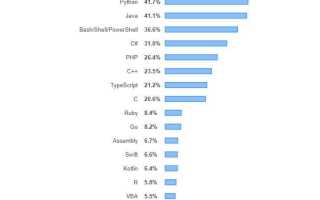
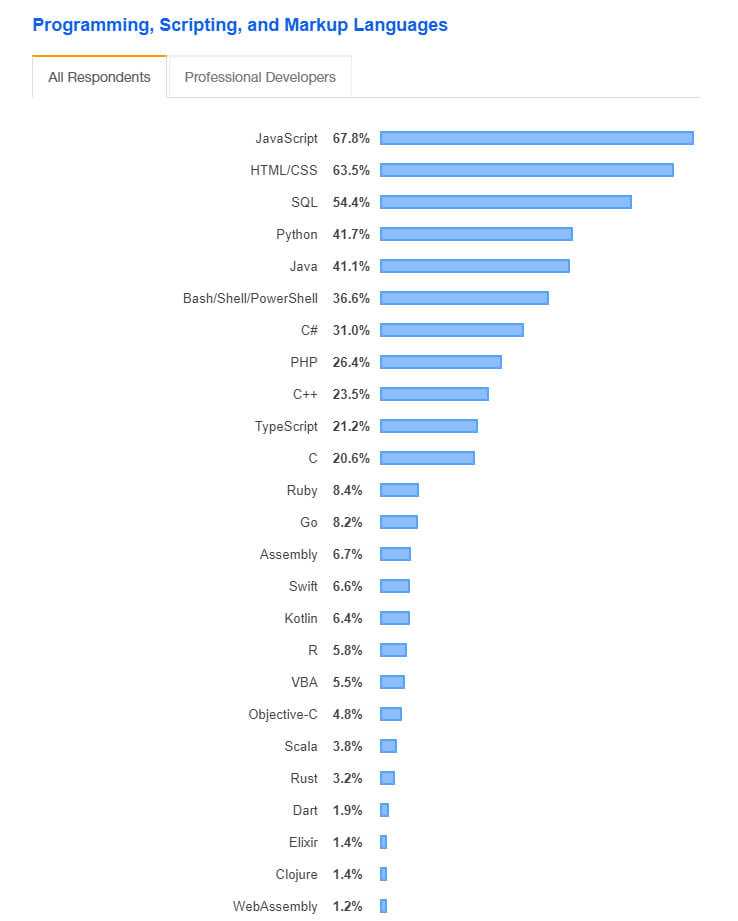
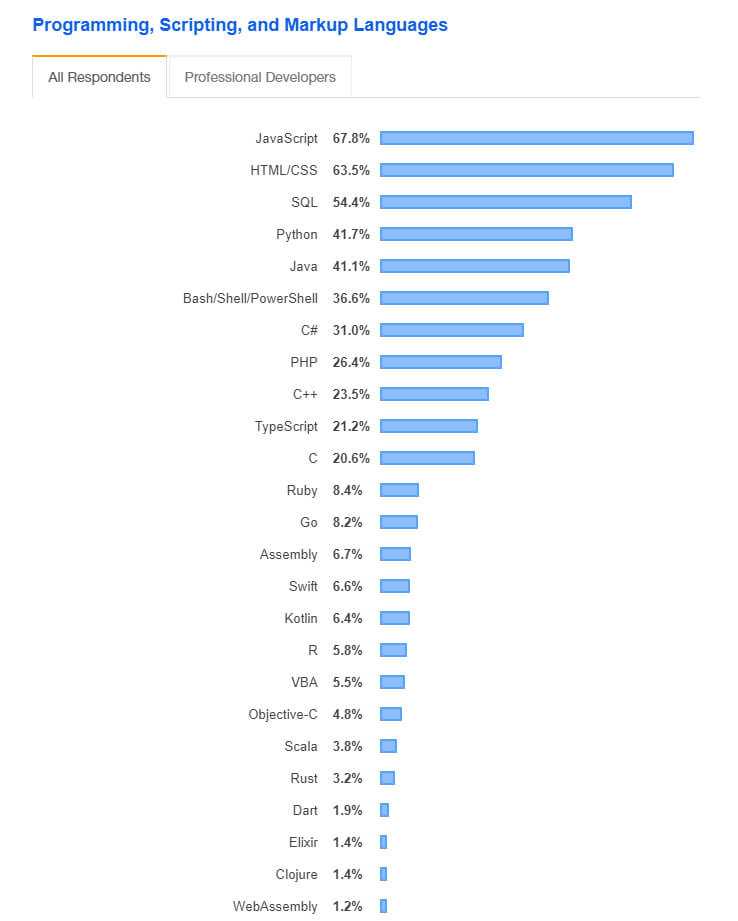
Выбор языка программирования для анализа данных напрямую влияет на скорость обработки информации и точность моделей. Python остается лидером благодаря библиотекам Pandas, NumPy и Scikit-learn, которые позволяют выполнять очистку данных, расчет статистических показателей и построение машинного обучения без необходимости писать сложные алгоритмы вручную. На крупных данных Python показывает эффективность при использовании Dask и PySpark.
R сохраняет преимущество в сложной статистике и визуализации. Функции ggplot2 и lattice обеспечивают точное и наглядное отображение распределений, а встроенные тесты гипотез и регрессионные модели позволяют экономить время на проверку гипотез. Для биостатистики и эконометрики R часто предпочтительнее Python из-за богатой библиотеки специализированных пакетов.
Julia набирает популярность в задачах с интенсивными вычислениями. Она сочетает простоту синтаксиса с производительностью, сравнимой с C. Модули DataFrames.jl и StatsModels.jl обеспечивают работу с большими наборами данных и сложные регрессионные анализы, при этом ускоряя вычисления по сравнению с Python и R.
Для интеграции с корпоративными базами данных и визуализации отчетов часто используют SQL и SAS. SQL позволяет эффективно агрегировать и фильтровать данные на уровне сервера, снижая нагрузку на аналитическую среду, а SAS обеспечивает стандартизированные методы статистического анализа, что важно для финансовых и медицинских приложений.
При выборе языка важно учитывать объем данных, требования к скорости обработки и необходимость специализированных статистических моделей. Для большинства проектов начальной и средней сложности Python предоставляет оптимальный баланс гибкости и библиотечной поддержки, R эффективен при глубокой статистике и визуализации, а Julia подходит для проектов с высокими вычислительными нагрузками.
Использование Python для обработки больших массивов данных
Python зарекомендовал себя как основной инструмент для работы с большими данными благодаря богатому набору библиотек и возможности интеграции с распределёнными системами. Для эффективной обработки массивов данных чаще всего используют pandas и NumPy. Pandas позволяет манипулировать таблицами размером до десятков миллионов строк при использовании chunking и memory mapping, а NumPy обеспечивает векторизированные операции, ускоряющие вычисления на порядки по сравнению с циклической обработкой.
Для данных, превышающих объём оперативной памяти, применяют Dask или Vaex. Dask позволяет распределять вычисления на нескольких ядрах или узлах кластера, сохраняя API, совместимый с pandas. Vaex оптимизирован для ленивой загрузки и фильтрации колонок, что сокращает потребление памяти до 90% при работе с терабайтными CSV и HDF5-файлами.
Python активно интегрируется с системами хранения данных и потоковой обработки: PySpark позволяет работать с Hadoop и Spark, обеспечивая параллельные трансформации и агрегации на больших кластерах. При этом использование DataFrame API снижает риск ошибок по сравнению с написанием низкоуровневого RDD-кода.
Для ускорения вычислений в критичных узлах применяют Numba и Cython. Numba компилирует функции с числовыми операциями в машинный код с поддержкой многопоточности, что снижает время обработки больших массивов на 50–200% в зависимости от задачи. Cython позволяет интегрировать Python с C для обработки массивов данных на уровне ядра, сохраняя удобство синтаксиса Python.
При работе с многомиллионными строками важно правильно организовать хранение данных: Parquet и Feather обеспечивают сжатие и быстрый доступ к колонкам, а HDF5 удобен для многомерных массивов и хранения промежуточных вычислений. Комбинация оптимизированных форматов с библиотеками для ленивой загрузки позволяет Python обрабатывать данные объёмом до сотен гигабайт на стандартных серверах.
Оптимизация кода включает использование vectorized operations, фильтрацию колонок перед загрузкой, минимизацию преобразований типов и применение batch processing для поэтапной обработки больших файлов. Эти практики позволяют Python оставаться высокопроизводительным инструментом при анализе и подготовке данных к статистическим моделям и машинному обучению.
Применение R для построения статистических моделей
R предоставляет обширный инструментарий для построения регрессионных моделей, анализа временных рядов и кластеризации. Для линейной регрессии используется функция lm(), позволяющая оценивать коэффициенты модели методом наименьших квадратов и проводить тесты значимости переменных через summary(). Для нелинейных зависимостей применяют nls(), а для логистической регрессии – glm() с аргументом family = binomial.
При анализе временных рядов R предлагает пакеты forecast и tsibble для автоматического выбора оптимальных моделей ARIMA и ETS. Функция auto.arima() автоматически определяет порядок модели по критериям AIC и BIC, а accuracy() оценивает прогнозную точность. Для сезонных данных используется stlm() с сезонной декомпозицией.
Кластеризация реализуется через kmeans() и hclust(). Рекомендуется масштабировать данные перед применением K-средних с помощью scale() для корректного расчета расстояний. Иерархическая кластеризация поддерживает различные метрики расстояний и методы объединения, включая Ward.D2 для минимизации внутрикластерной вариативности.
R также позволяет оценивать качество моделей с помощью перекрестной проверки. Пакет caret предоставляет функцию train(), которая автоматизирует подбор гиперпараметров, разделение выборки и расчет метрик точности. Для визуализации результатов применяются ggplot2 и lattice, обеспечивающие построение графиков остатков, коэффициентов и кластерных диаграмм.
Для крупных наборов данных рекомендуется использовать data.table и пакет parallel для оптимизации скорости вычислений и параллельной обработки. Это позволяет строить модели на миллионах наблюдений без значительного замедления. R обеспечивает интеграцию с Python через reticulate, что расширяет возможности статистического моделирования и обработки данных.
SQL для выборки и агрегации данных из баз
SQL (Structured Query Language) остается ключевым инструментом для анализа структурированных данных. Он позволяет быстро извлекать, фильтровать и агрегировать большие объемы информации из реляционных баз данных.
Для выборки данных используются операторы SELECT, FROM и WHERE. Они обеспечивают точное указание столбцов, источников данных и условий фильтрации. Например, для извлечения продаж за определенный месяц применяют условия вида WHERE sale_date BETWEEN ‘2026-01-01’ AND ‘2026-01-31’.
Агрегатные функции SQL позволяют суммировать, усреднять и подсчитывать записи:
- COUNT() – подсчет строк, соответствующих условию.
- SUM() – суммирование числовых значений.
- AVG() – вычисление среднего значения.
- MIN() и MAX() – определение минимального и максимального значения.
Для группировки данных используют GROUP BY. Это особенно полезно при анализе продаж по регионам, продуктам или временным интервалам. Например, GROUP BY region позволяет получить суммарные продажи по каждому региону.
Для фильтрации агрегированных данных применяется HAVING. Он работает аналогично WHERE, но применяется к результатам группировки. Например, HAVING SUM(sales) > 100000 выделяет только регионы с продажами выше 100 тысяч.
Соединение таблиц (JOIN) позволяет объединять данные из нескольких источников. Чаще всего используют:
- INNER JOIN – возвращает строки, где есть совпадения в обеих таблицах.
- LEFT JOIN – возвращает все строки из левой таблицы с соответствиями из правой.
- RIGHT JOIN – аналогично LEFT JOIN, но с приоритетом правой таблицы.
Оптимизация запросов важна при работе с большими базами. Рекомендации включают:
- Использование индексов на часто фильтруемых и агрегируемых колонках.
- Выбор только необходимых столбцов вместо SELECT *.
- Применение условий WHERE до агрегирования для сокращения объема данных.
- Разделение сложных запросов на подзапросы для повышения читаемости и производительности.
SQL обеспечивает точный контроль над выборкой и агрегацией, что делает его незаменимым при подготовке данных для статистического анализа и визуализации.
Julia для ускорения вычислений при численных экспериментах
Julia – специализированный язык для высокопроизводительных вычислений, сочетающий синтаксис, похожий на Python, с производительностью близкой к C. Основное преимущество Julia заключается в компиляции Just-In-Time (JIT) через LLVM, что позволяет выполнять численные эксперименты с минимальными накладными расходами. В типичных задачах линейной алгебры, например при умножении матриц размером 10 000×10 000, Julia демонстрирует ускорение в 5–10 раз по сравнению с интерпретируемыми языками, такими как Python с NumPy.
Для оптимизации вычислений рекомендуется использовать типизированные массивы и избегать глобальных переменных. Например, объявление массивов через Array{Float64,2} позволяет компилятору генерировать машинный код высокой эффективности. В задачах с большим количеством итераций, таких как Монте-Карло симуляции, применение многопоточности через макрос @threads даёт линейный прирост производительности на современных многопроцессорных системах.
Julia поддерживает интеграцию с BLAS и LAPACK, что позволяет использовать оптимизированные библиотеки для линейной алгебры без дополнительной настройки. Для численного дифференцирования и оптимизации подходит пакет ForwardDiff.jl, который обеспечивает автоматическое дифференцирование с высокой точностью и скоростью, исключая необходимость ручного вычисления производных. Для больших массивов данных эффективнее использовать пакет StaticArrays.jl, который уменьшает накладные расходы на аллокацию памяти при операциях над небольшими фиксированными матрицами.
Для распределённых вычислений в Julia доступен стандартный модуль Distributed, позволяющий распараллеливать задачи на кластере без изменения основной структуры кода. Эксперименты показывают, что при распараллеливании симуляций стохастических моделей на 16 ядрах ускорение достигает 12–14 раз, что практически линейно по сравнению с числом процессоров.
При работе с Julia важно профилировать код с помощью встроенного профайлера @profile и устранять узкие места на уровне конкретных функций. Оптимизация на уровне алгебраических операций и эффективное использование типов данных чаще всего дают больший прирост, чем сложные архитектурные изменения.
MATLAB для анализа сигналов и матричных операций
MATLAB предоставляет комплексные инструменты для обработки сигналов, включая функции fft, filter и spectrum, позволяющие выполнять спектральный анализ, фильтрацию и оценку мощности сигналов. Для работы с дискретными и непрерывными временными рядами доступны встроенные объекты timeseries и timetable, которые упрощают интерполяцию, ресемплирование и синхронизацию данных.
Матричные операции в MATLAB оптимизированы под многомерные массивы и позволяют выполнять линейную алгебру без явных циклов. Функции inv, eig и svd обеспечивают быстрое решение систем линейных уравнений, вычисление собственных значений и сингулярное разложение, что критично при обработке больших объемов данных.
Для анализа сигналов с высокой точностью MATLAB поддерживает вейвлет-преобразования через Toolbox Wavelet, что позволяет выявлять локальные особенности в шумных данных. Функции cwt и wt удобны для исследования нестационарных сигналов, а filterDesigner обеспечивает проектирование FIR и IIR фильтров с точной частотной характеристикой.
MATLAB позволяет комбинировать матричные вычисления с визуализацией в реальном времени. Функции plot, surf и imagesc поддерживают динамическое отображение спектров, временных рядов и многомерных массивов, облегчая интерпретацию сложных сигналов. Использование parfor и GPU-массивов ускоряет обработку больших данных без изменения синтаксиса кода.
Для практических проектов рекомендуется структурировать данные в виде матриц и временных рядов, использовать встроенные фильтры и преобразования, а для анализа больших объемов сигналов – задействовать параллельные вычисления и специализированные Toolbox, такие как Signal Processing Toolbox и Wavelet Toolbox, что позволяет сократить время экспериментов и повысить точность анализа.
SAS для корпоративной аналитики и отчетности
SAS (Statistical Analysis System) представляет собой мощную платформу для корпоративной аналитики, позволяющую обрабатывать объемные массивы данных и строить детализированные отчеты с высокой точностью. Основное преимущество SAS – интеграция с различными источниками данных, включая SQL-базы, Hadoop-кластеры и облачные хранилища, что обеспечивает централизованный доступ к корпоративной информации.
В корпоративных средах SAS часто используется совместно с SAS Visual Analytics, обеспечивая интерактивные панели и визуализацию данных в реальном времени. Применение предиктивной аналитики через SAS Enterprise Miner позволяет строить модели прогнозирования спроса, выявления рисков и сегментации клиентов, что повышает эффективность стратегического планирования.
Для внедрения SAS в компании рекомендуется соблюдать следующие практики:
- Стандартизировать код отчетности и процедуры, чтобы уменьшить дублирование и повысить читаемость;
- Настроить автоматическую генерацию отчетов с помощью SAS Batch Processing и планировщиков задач;
- Регулярно использовать data quality checks, чтобы гарантировать корректность и актуальность корпоративных данных;
- Обучать сотрудников специфике процедур SAS, включая макропрограммирование, для ускорения разработки сложных аналитических процессов.
SAS обеспечивает надежную и масштабируемую платформу для корпоративной аналитики, где точность обработки, интеграция с системами предприятия и возможности визуализации данных формируют основу эффективной отчетности и стратегического анализа.
Scala и Spark для распределенной обработки данных
Scala – статически типизированный язык, сочетающий функциональный и объектно-ориентированный подход, что делает его оптимальным для больших данных. Apache Spark, изначально написанный на Scala, обеспечивает высокую производительность распределенной обработки благодаря in-memory вычислениям и DAG-планированию задач.
Ключевые возможности использования Scala и Spark в аналитике данных:
- Resilient Distributed Dataset (RDD): фундаментальная структура Spark для хранения данных в распределенной памяти с поддержкой трансформаций и действий.
- DataFrame и Dataset API: позволяют работать с структурированными данными, обеспечивая типобезопасность и оптимизацию через Catalyst Optimizer.
- Машинное обучение: MLlib предоставляет алгоритмы кластеризации, регрессии и классификации, которые можно масштабировать на кластере.
- Spark SQL: интеграция с SQL-запросами позволяет выполнять сложные агрегации и соединения без потери производительности.
- Стриминговая обработка: Structured Streaming поддерживает обработку данных в реальном времени с низкой задержкой.
Рекомендации по оптимизации производительности:
- Использовать persist(StorageLevel.MEMORY_AND_DISK) для больших промежуточных данных, чтобы избежать повторного вычисления RDD.
- Предпочитать Dataset API DataFrame для структурированных данных из-за оптимизации планировщика и снижения GC нагрузок.
- Настраивать partitions исходя из объема кластера: обычно 2–3 партиции на каждое ядро обеспечивают баланс между параллелизмом и накладными расходами.
- Использовать broadcast joins для малых таблиц, чтобы минимизировать shuffle и ускорить соединения.
- Профилировать задачи через Spark UI для выявления узких мест: длительные стадии, большой shuffle, skew данных.
Scala и Spark особенно эффективны при работе с петабайтными наборами данных, потоками логов и аналитикой в реальном времени. Комбинация функционального программирования Scala и распределенной архитектуры Spark позволяет строить устойчивые, масштабируемые и управляемые пайплайны обработки данных.
Использование JavaScript и D3.js для визуализации статистики
D3.js позволяет связывать данные с элементами DOM и создавать интерактивные графики без использования Canvas. Для построения линейных графиков достаточно применить методы d3.scaleLinear() для осей, d3.line() для генерации линии и d3.select() для вставки элементов SVG в документ. Для больших наборов данных оптимально использовать d3.nest() для группировки и агрегации перед визуализацией, что снижает нагрузку на браузер.
Bar charts можно строить с использованием d3.scaleBand() для категорий и d3.scaleLinear() для значений. Для динамических обновлений данных применяется метод .data().join(), который позволяет добавлять, удалять и изменять столбцы без полной перерисовки графика.
При работе с временными рядами d3.timeParse() и d3.scaleTime() упрощают обработку дат и интервальных данных. Для улучшения читаемости графиков рекомендуется использовать d3.axisBottom() и d3.axisLeft() с кастомными форматами tickFormat, чтобы отображать даты и числа в удобном виде.
Для интерактивности можно применять события mouseover и mouseout, создавая подсказки с помощью d3.select().append(‘div’) и изменения стилей через .style(). Для сложных визуализаций, таких как heatmaps или treemaps, D3 предоставляет модуль d3-hierarchy, позволяющий автоматически рассчитывать размеры и позиции элементов в соответствии с данными.
Оптимизация производительности достигается через ограничение числа DOM-элементов, использование d3.transition() для анимаций и кэширование расчетов масштабов при обновлении данных. D3.js совместим с JSON и CSV, что облегчает интеграцию статистических данных из внешних источников без дополнительной обработки.
Использование D3.js обеспечивает гибкий контроль над визуализацией и точное отображение статистических закономерностей, включая распределения, корреляции и тренды, что делает его предпочтительным инструментом для интерактивной аналитики на веб-платформе.
Вопрос-ответ:
Какие языки программирования чаще всего применяются для статистического анализа?
Для статистического анализа традиционно используют R и Python. R возник как специализированный язык для работы с данными, имеет богатый набор пакетов для статистики и визуализации. Python универсален и популярен благодаря библиотекам NumPy, pandas, SciPy и matplotlib, которые позволяют проводить обработку данных, анализ и создавать графики. Выбор языка зависит от задач: если нужна глубокая статистическая обработка и визуализация, часто выбирают R, если требуется интеграция анализа с другими системами — Python.
В чем преимущества Python перед другими языками для обработки больших массивов данных?
Python известен удобством работы с большими данными благодаря библиотекам pandas и Dask, которые позволяют хранить и обрабатывать таблицы миллионов строк, а также выполнять параллельные вычисления. Его интеграция с SQL, Hadoop и другими инструментами делает язык гибким для анализа данных в бизнесе и науке. Кроме того, Python поддерживает машинное обучение через библиотеки scikit-learn и TensorFlow, что упрощает работу с прогнозированием и классификацией.
Почему R до сих пор пользуется популярностью среди статистиков?
R сохраняет популярность благодаря большому количеству специализированных пакетов для статистического моделирования, тестирования гипотез и визуализации. Он позволяет создавать графики высокого качества, легко строить регрессионные модели, кластеризацию и временные ряды. Сообщество R активно публикует пакеты и руководства, что облегчает работу с новыми методами анализа и делает язык удобным для научных исследований.
Можно ли использовать несколько языков одновременно для анализа данных?
Да, комбинирование языков встречается довольно часто. Например, Python применяют для обработки данных и построения моделей, а R — для построения графиков и сложной статистической проверки. Существуют инструменты, позволяющие интегрировать R-код в Python и наоборот, что позволяет использовать сильные стороны обоих языков в одной задаче, не ограничиваясь возможностями одного языка.

 Загрузка...