Содержание статьи
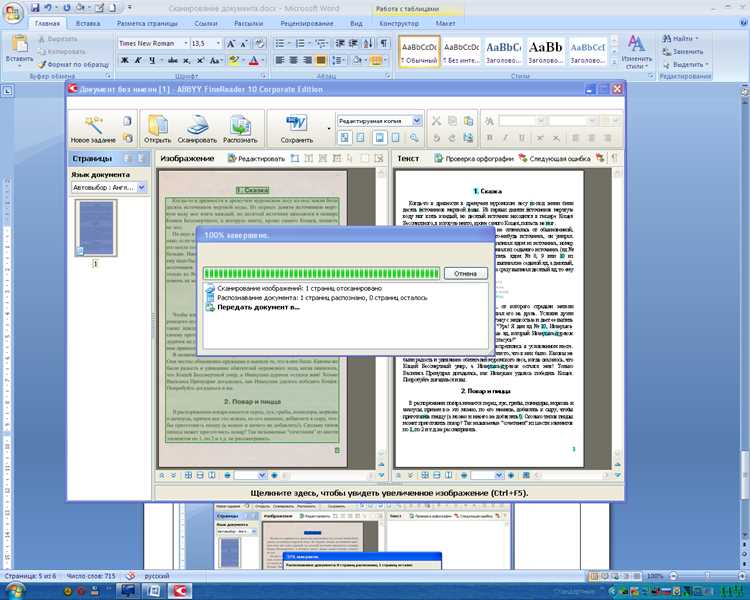
Сканы документов часто требуют доработки перед использованием: удаления артефактов, выравнивания текста, корректировки контрастности. Word не предназначен для профессиональной обработки изображений, но его встроенные функции позволяют решить 80% задач без сторонних программ. В этом руководстве – только рабочие методы, проверенные на сканах с разрешением от 150 до 600 dpi.
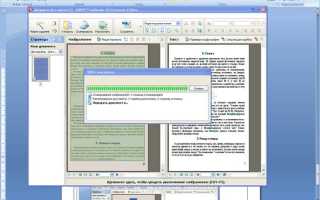
Первый шаг – конвертация скана в редактируемый текст. Word распознаёт текст через OCR (оптическое распознавание символов) при вставке изображения. Для этого откройте новый документ, перейдите на вкладку Вставка → Рисунки и выберите файл скана. После загрузки щёлкните по изображению правой кнопкой мыши и выберите Распознать текст. Точность распознавания зависит от качества скана: при 300 dpi и чётком шрифте (например, Arial 12pt) ошибок будет не более 2–3%.
Если текст распознался с ошибками, используйте инструмент «Исправление текста». Выделите проблемный фрагмент и нажмите Ctrl+H для вызова окна замены. Вводите ошибочные символы (например, «rn» вместо «m») и заменяйте их на правильные. Для массовой корректировки применяйте регулярные выражения: в поле Найти введите [а-я]{1,2}\s[А-Я], чтобы найти слипшиеся слова с заглавными буквами.
Сканы с низким разрешением или цветным фоном требуют предварительной обработки. В Word нет инструментов для удаления шумов, но можно использовать фильтры контрастности. Выделите изображение, перейдите на вкладку Формат рисунка → Коррекция и выберите предустановку Увеличить контрастность или Чёрно-белое. Для точной настройки нажмите Параметры коррекции и отрегулируйте ползунки Яркость и Контрастность в диапазоне от +20% до +40%.
После распознавания текста часто остаются лишние элементы: рамки, штампы, пятна. Удаляйте их вручную с помощью инструмента Удаление фона (вкладка Формат рисунка). Обведите область маркером и нажмите Сохранить изменения. Для сложных случаев используйте обрезку по контуру: выделите изображение, перейдите в Формат рисунка → Обрезка → Обрезка по фигуре и выберите прямоугольник, чтобы скрыть ненужные края.
Финальный этап – форматирование текста. Word сохраняет исходное форматирование скана, включая переносы строк и отступы. Удалите лишние пробелы и разрывы строк с помощью Ctrl+H: в поле Найти введите ^p (разрыв абзаца) или ^l (разрыв строки), а в поле Заменить на – пробел. Для выравнивания текста по ширине выделите его и нажмите Ctrl+J. Шрифт рекомендуется заменить на стандартный (Calibri 11pt или Times New Roman 12pt) для совместимости с другими документами.
Как преобразовать отсканированный документ в редактируемый текст
Первый шаг – выбор правильного разрешения при сканировании. Оптимальное значение для текста – 300 DPI: ниже качество распознавания ухудшится, выше – увеличит размер файла без заметной пользы. Используйте монохромный режим (черно-белый) для печатных документов, а для цветных или с графикой – 24-битный цвет. Формат сохранения – TIFF или PNG, так как они сохраняют четкость без сжатия с потерями, в отличие от JPEG.
Для распознавания текста подойдут специализированные OCR-инструменты. ABBYY FineReader (версия 15 и новее) обрабатывает даже сложные макеты с таблицами и колонками, поддерживая 200+ языков. Tesseract OCR (бесплатный, с открытым кодом) требует предварительной обработки изображения: удаления шумов, выравнивания наклона и повышения контрастности. Встроенные средства Word (меню «Файл» → «Преобразовать в текст») справляются только с простыми документами без форматирования.
После распознавания проверьте результат вручную. Частые ошибки: замена «о» на «0», «л» на «1», слияние слов при некачественном скане. Используйте функцию «Найти и заменить» для массовой правки повторяющихся ошибок. Для документов с таблицами экспортируйте данные в Excel через FineReader, чтобы сохранить структуру ячеек – Word часто нарушает выравнивание.
Сохраните итоговый файл в формате DOCX с включенной опцией «Сохранить исходное форматирование». Если документ содержит изображения, вставьте их отдельно после распознавания текста, чтобы избежать артефактов. Для юридических или финансовых документов используйте режим «Точное копирование» в FineReader, чтобы сохранить нумерацию страниц и колонтитулы.
Настройка параметров распознавания текста перед импортом в Word
Перед запуском OCR-распознавания в программах типа ABBYY FineReader или Adobe Acrobat Pro DC установите разрешение скана не ниже 300 DPI. Для текстов с мелким кеглем (8–10 пт) или сложными шрифтами (готические, рукописные) увеличьте значение до 400–600 DPI. Низкое разрешение (200 DPI и ниже) приводит к потере деталей символов, что увеличивает количество ошибок распознавания на 15–20%, особенно в таблицах и формулах.
Выберите язык документа в настройках OCR-движка. Для многоязычных текстов укажите все используемые языки – это снижает вероятность замены символов на схожие из других алфавитов (например, кириллическая «а» на латинскую «a»). В FineReader 15 поддерживается одновременное распознавание до 200 языков, но активация лишних языков замедляет процесс на 5–7% без улучшения точности.
Настройте параметры сегментации страницы. Для документов с колонками, врезками или иллюстрациями включите опцию «Распознавать структуру документа» (в FineReader – «Анализ макета»). Это предотвращает склеивание текста из разных блоков. Для сканов с низким контрастом (например, газетные вырезки) используйте предварительную бинаризацию с порогом 120–150 по шкале 0–255 – это отделяет текст от фона без потери четкости.
Отключите автоматическую коррекцию орфографии на этапе распознавания. Встроенные словари могут заменять редкие термины, аббревиатуры или имена собственные на похожие слова из словаря, что искажает исходный текст. В Adobe Acrobat Pro DC эту опцию можно деактивировать в разделе «Настройки распознавания текста» → «Язык» → снять флажок «Проверять орфографию«.
Для документов с таблицами активируйте режим «Распознавать таблицы» и укажите тип разделителей (линии, пробелы, табуляция). В FineReader используйте шаблон «Таблица с границами» для четких линий или «Таблица без границ» для данных, разделенных пробелами. Проверьте результат на тестовой странице: если ячейки сливаются, уменьшите чувствительность распознавания границ на 10–15%.
Исправление ошибок распознавания символов вручную
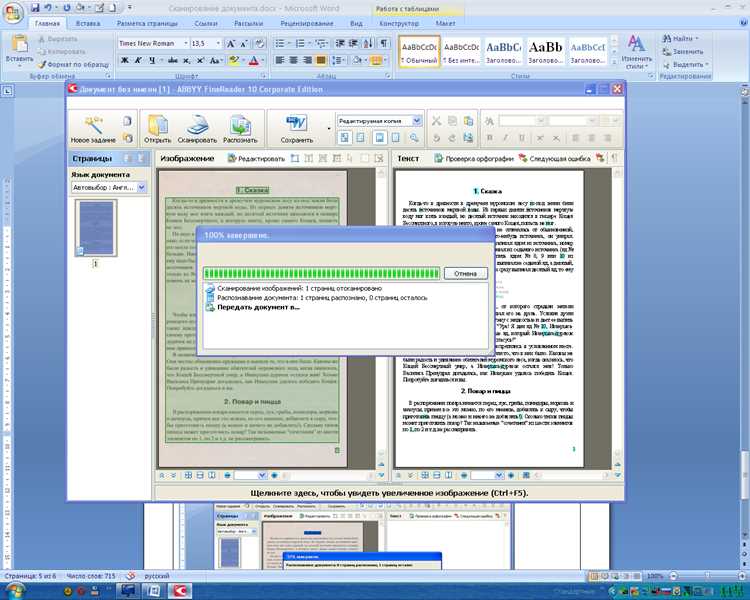
После автоматического распознавания текста в Word через OCR (например, ABBYY FineReader или встроенный инструмент Microsoft) остаются ошибки: перепутанные буквы, слипшиеся слова, неверные символы. Чаще всего страдают схожие по начертанию символы – «о» и «0», «л» и «1», «н» и «и». Проверку начинайте с визуального сравнения скана и распознанного текста, выделяя участки с подозрительными фрагментами.
Используйте функцию «Найти и заменить» (Ctrl+H) для массовой правки однотипных ошибок. Например, замените все вхождения «rn» на «m» (частая ошибка при распознавании курсива) или «cl» на «d». Учитывайте контекст: замена «3» на «З» уместна только в кириллическом тексте, а в цифровых данных приведёт к искажениям. Для точечной правки переключайтесь между режимами «Черновик» и «Разметка страницы» – так легче сопоставлять текст с исходным изображением.
Обращайте внимание на знаки препинания: OCR часто путает дефис (-) с тире (–), точку с запятой, кавычки («») с лапками („“). В Word используйте сочетания клавиш для вставки правильных символов: Alt+0151 для длинного тире, Alt+0133 для многоточия. Если в тексте встречаются формулы или специальные символы (например, ©, ±), вставляйте их через «Вставка → Символ» или используйте таблицу Unicode (Win + .).
Для проверки орфографии активируйте встроенный словарь Word (F7), но не полагайтесь на него полностью – он не распознаёт редкие термины, аббревиатуры или имена собственные. Добавьте часто встречающиеся ошибки в пользовательский словарь (через «Файл → Параметры → Правописание → Пользовательские словари»), чтобы избежать повторных исправлений. При работе с техническими текстами создайте отдельный словарь для терминов.
Если текст содержит таблицы, проверяйте не только содержимое ячеек, но и их границы. OCR часто объединяет или разрывает ячейки, а также переносит текст за пределы таблицы. Восстанавливайте структуру вручную: выделяйте проблемные участки, используйте инструмент «Макет таблицы» для слияния или разделения ячеек. Для сложных таблиц с объединёнными ячейками экспортируйте данные в Excel, исправляйте там, затем возвращайте в Word.
Сохраняйте промежуточные версии документа с суффиксами в имени файла (например, «Договор_распознанный_v1.docx», «Договор_исправленный_v2.docx»). Это позволит вернуться к предыдущему состоянию, если правки ухудшат результат. После завершения редактирования экспортируйте текст в PDF и сравните с исходным сканом в режиме наложения (например, через Adobe Acrobat) – так выявите пропущенные ошибки.
Форматирование текста после распознавания: выравнивание, шрифты, интервалы
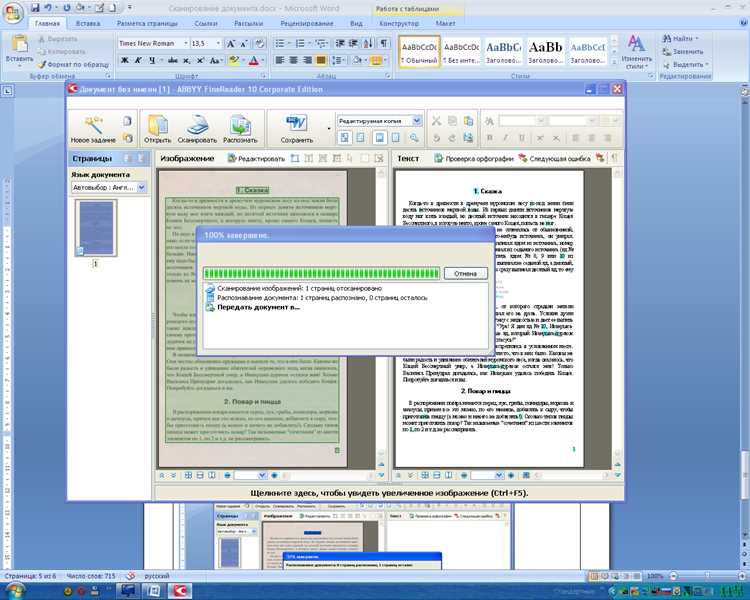
После распознавания скана в Word текст часто выглядит неструктурированным: абзацы сливаются, шрифты не соответствуют оригиналу, а выравнивание нарушено. Первым шагом исправьте выравнивание. Для основного текста используйте по левому краю (Ctrl+L), для заголовков – по центру (Ctrl+E), а для таблиц или подписей – по правому краю (Ctrl+R). Если документ содержит цитаты или врезки, примените выравнивание по ширине (Ctrl+J) с автоматической расстановкой переносов (Разметка страницы → Расстановка переносов → Авто).
Шрифты требуют особого внимания. Стандартные гарнитуры для деловых документов: Times New Roman (14 пт) или Arial (12 пт). Для заголовков увеличьте кегль на 2–4 пункта и используйте полужирное начертание. Избегайте декоративных шрифтов (например, Comic Sans) – они снижают читаемость. Если оригинал содержал курсив или подчеркивание, восстановите их выборочно: курсив для терминов (Ctrl+I), подчеркивание – только для ссылок (Ctrl+U). Проверьте межсимвольные интервалы: для плотного текста установите уплотненный на 0,5 пт (Шрифт → Дополнительно → Интервал), для разреженного – разреженный на 1 пт.
- Интервалы между абзацами: 6 пт до и 0 пт после для основного текста, 12 пт до для заголовков.
- Междустрочный интервал: 1,15 для черновиков, 1,5 для официальных документов, одинарный – для таблиц.
- Отступ первой строки: 1,25 см (не табуляция!). Настройте через Абзац → Отступы и интервалы → Первая строка.
Для массового форматирования используйте стили. Создайте базовый стиль «Основной текст» с параметрами: Times New Roman 14 пт, выравнивание по левому краю, отступ 1,25 см, интервал 1,15. Примените его ко всему документу (Ctrl+A → выберите стиль). Для заголовков создайте отдельные стили с наследованием: «Заголовок 1» (16 пт, полужирный, интервал 12 пт до), «Заголовок 2» (15 пт, полужирный курсив). Это ускорит редактирование и обеспечит единообразие. Проверьте результат в режиме Структура (Вид → Структура) – там видны только заголовки, что помогает выявить ошибки в иерархии.
Вставка и редактирование таблиц из отсканированных документов
После распознавания текста с помощью OCR (например, ABBYY FineReader или встроенного в Word инструмента «Преобразовать в текст») таблицы часто теряют форматирование. Чтобы восстановить структуру, выделите распознанный текст таблицы и перейдите на вкладку Вставка → Таблица → Преобразовать текст в таблицу. Укажите количество столбцов (ориентируйтесь на исходный документ) и разделитель – обычно это табуляция или точка с запятой. Если границы ячеек не отображаются, выделите таблицу и выберите Макет → Отобразить сетку. Для сложных таблиц с объединёнными ячейками используйте Макет → Объединить ячейки или Разделить ячейки, предварительно выделив нужные области.
Частые ошибки при редактировании:
- Неравномерные столбцы – исправляйте через Макет → Автоподбор → Автоподбор по содержимому или вручную перетаскивая границы.
- Смещённые данные – проверяйте выравнивание текста в ячейках (Выровнять по центру, По верхнему краю).
- Лишние разрывы строк – удаляйте их клавишей Backspace или заменяйте на пробелы через Заменить → Специальный → Знак абзаца.
- Пропущенные границы – применяйте стили границ через Конструктор таблиц → Границы, выбирая нужный тип линии (например, 0,5 пт для тонких границ).
Для точного соответствия исходнику используйте инструмент Сравнить документы (вкладка Рецензирование), чтобы выявить расхождения в данных.
Работа с изображениями внутри отсканированного файла
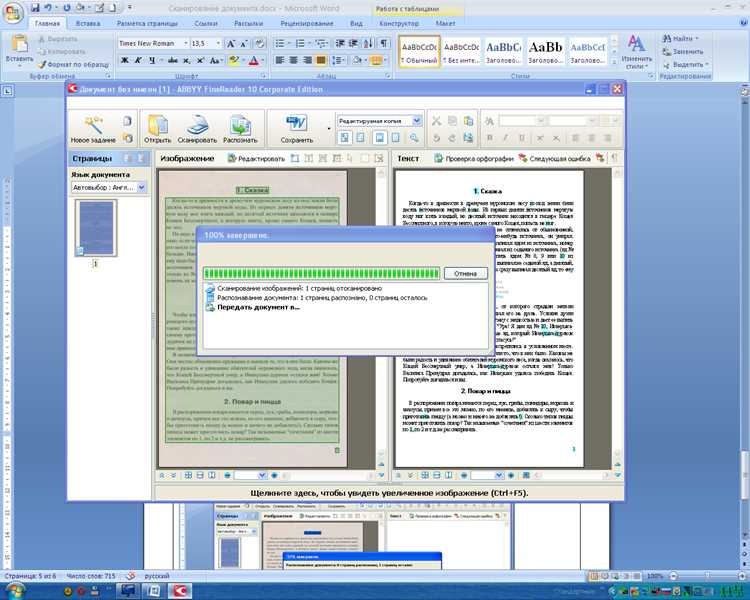
После вставки скана в Word выделите изображение и перейдите на вкладку Формат рисунка. Нажмите Удалить фон для автоматического вырезания фона – инструмент корректно распознаёт контрастные области, но требует ручной доработки при сложных границах. Для точной обрезки используйте Обрезка с параметром Соотношение сторон или Форма, чтобы сохранить пропорции. Если скан содержит текст на фоне, примените Коррекция → Резкость (+20–30%) и Яркость/Контрастность (яркость +10%, контраст +15%) для улучшения читаемости.
Для замены или редактирования отдельных элементов скана используйте Надпись (вкладка Вставка) поверх изображения. Настройте прозрачность заливки на 0% и обведите границы надписи без контура. При необходимости вставки нового изображения поверх скана выровняйте его по сетке (Макет → Выровнять → Сетка) или привяжите к тексту с обтеканием Перед текстом. Для массовой обработки однотипных сканов сохраните настройки формата как стиль (Формат рисунка → Стили рисунков → Сохранить как новый стиль).
Сохранение и экспорт отредактированного документа в нужный формат
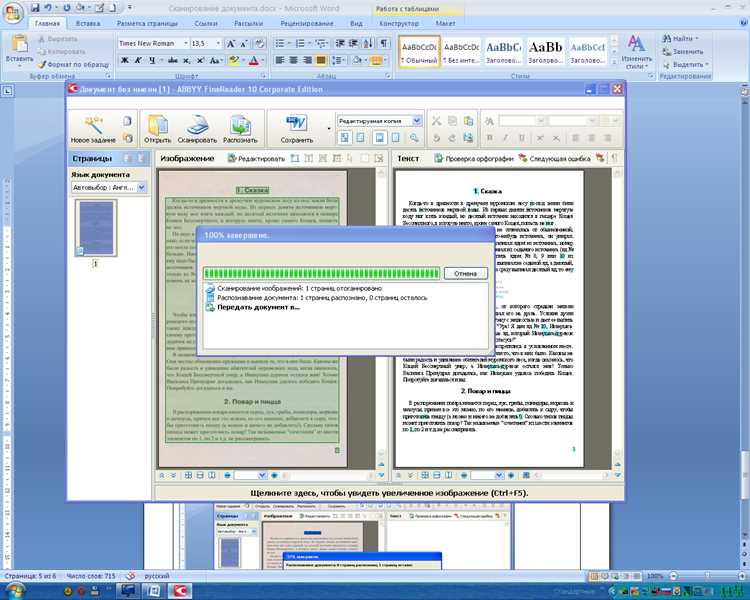
После завершения редактирования скана в Word критически важно выбрать оптимальный формат сохранения, учитывая дальнейшее использование файла. Стандартный формат .docx сохраняет все элементы форматирования, но увеличивает размер файла на 15–30% по сравнению с PDF. Для документов, требующих минимального веса при сохранении читаемости, подойдет .pdf с настройками сжатия изображений: выберите «Стандартное (для публикации в Интернете и печати)» в разделе «Оптимизация для». Это сократит объем на 40–60% без потери качества текста.
Для экспорта в форматы, совместимые с устаревшими системами или специфическими программами, используйте параметры «Сохранить как». Формат .rtf поддерживает базовое форматирование и совместим с большинством текстовых редакторов, включая LibreOffice и OpenOffice, но теряет сложные элементы (таблицы с объединенными ячейками, сноски). Если документ содержит макросы или VBA-код, сохраняйте в .docm – обычный .docx их удалит. При работе с юридическими или архивными документами выбирайте .pdf/a (ISO 19005-1), который гарантирует долговременное хранение без потери данных.
| Формат | Совместимость | Сохраняет | Потери | Размер файла |
|---|---|---|---|---|
.docx |
Word 2007+, онлайн-редакторы | Все элементы форматирования, изображения, таблицы | Нет | Высокий |
.pdf |
Любые устройства с PDF-ридерами | Текст, изображения, гиперссылки | Интерактивные элементы (формы, макросы) | Средний (зависит от сжатия) |
.rtf |
Устаревшие редакторы, простые текстовые процессоры | Базовое форматирование, изображения | Таблицы с объединением, стили, сноски | Низкий |
.odt |
LibreOffice, OpenOffice | Большинство элементов Word | Некоторые макросы, специфичные стили | Средний |
При сохранении в PDF обратите внимание на параметры доступности: включите опцию «Теги для структуры документа» в разделе «Параметры». Это позволит скринридерам корректно озвучивать содержимое, а поисковым системам индексировать текст. Для документов с высоким разрешением сканов (300+ dpi) используйте сжатие «Высокое качество печати» – оно уменьшит размер файла на 20–30% без заметной потери деталей. Избегайте формата .jpg для экспорта страниц: он предназначен для изображений и не сохраняет текстовый слой, делая документ нередактируемым.
Если документ предназначен для печати, экспортируйте в PDF с разрешением 300 dpi и цветовым профилем CMYK (вместо RGB) – это предотвратит искажение цветов при типографской печати. Для веб-публикации выбирайте RGB и разрешение 150 dpi: этого достаточно для экранного отображения и сокращает размер файла в 2–3 раза. Перед окончательным сохранением проверьте документ через «Предварительный просмотр» (Ctrl+F2) – это позволит выявить обрезку текста или смещение элементов на разных устройствах.
Для автоматизации экспорта используйте макросы или надстройку «Сохранить как PDF/XPS». Пример макроса для пакетного сохранения всех открытых документов в PDF с оптимизацией:
Sub SaveAllAsPDF()
Dim doc As Document
For Each doc In Documents
doc.SaveAs2 FileName:=Replace(doc.FullName, ".docx", ".pdf"), _
FileFormat:=wdFormatPDF, _
OptimizeFor:=wdExportOptimizeForPrint
Next doc
End Sub
Этот код сохраняет каждый открытый документ в той же папке с заменой расширения, применяя настройки для печати. Для документов с конфиденциальной информацией добавьте пароль через параметр Password:="ваш_пароль" в методе SaveAs2.
Типичные проблемы при редактировании сканов и их решения
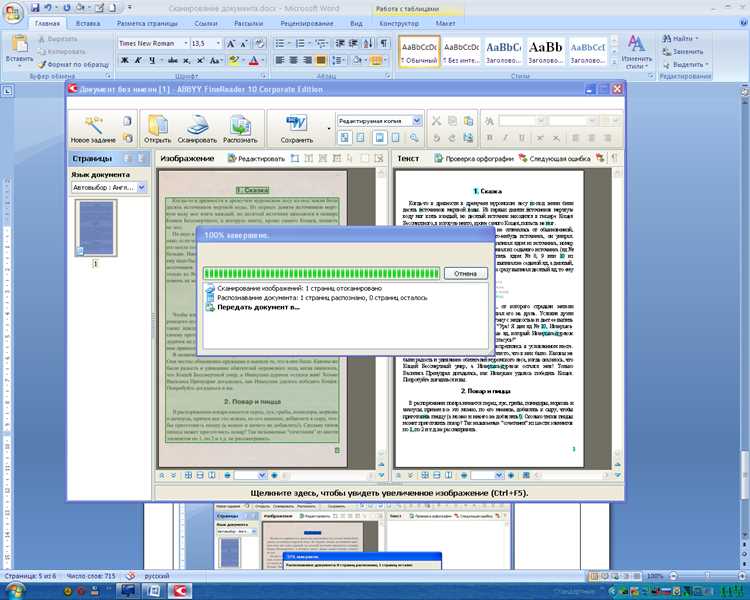
Сканы с низким разрешением (менее 300 dpi) часто превращаются в размытые или пикселизированные изображения при вставке в Word. Это затрудняет распознавание текста и редактирование. Решение: перед сканированием установите разрешение не ниже 300 dpi в настройках сканера. Если исходный файл уже низкого качества, используйте инструменты повышения резкости в Photoshop (Filter → Sharpen → Unsharp Mask) или бесплатные аналоги типа GIMP. Для текста применяйте параметры с радиусом 0,5–1,5 пикселя и порогом 3–5 уровней.
Неравномерная освещенность скана приводит к появлению теней или засветов, которые мешают распознаванию OCR-программами. Устраните проблему на этапе сканирования: используйте ровное освещение (например, два источника света по бокам) или сканируйте в режиме «Цветной документ» вместо «Черно-белый». В Word можно применить коррекцию яркости/контрастности через «Формат рисунка» → «Коррекции», но лучше исправить исходник в графическом редакторе с помощью инструмента «Уровни» (Ctrl+L в Photoshop).
Искажения перспективы возникают при сканировании книг или согнутых документов. Текст выглядит наклонным или деформированным, что снижает точность OCR. В Adobe Acrobat Pro используйте инструмент «Исправление перспективы» (Tools → Enhance Scans → Correct Perspective). Для бесплатных решений подойдет ScanTailor: загрузите скан, выделите углы страницы и примените автоматическую коррекцию. В Word такие искажения не исправить – требуется предварительная обработка.
Фоновые шумы (пятна, линии, муар) мешают распознаванию текста и ухудшают визуальное восприятие. Удалите их в графическом редакторе с помощью фильтра «Шумоподавление» (Filter → Noise → Reduce Noise) или инструмента «Штамп» для точечных дефектов. В Word можно попробовать «Удалить фон» (Формат рисунка → Удалить фон), но этот метод грубый и часто оставляет артефакты. Для цветных сканов с муаром используйте фильтр «Despeckle» в GIMP или настройте параметры сканирования (включите опцию «Устранение муара»).
Неправильное выравнивание текста после OCR приводит к смещению строк или символов. В Word это проявляется как «лесенка» из абзацев. Исправьте через «Макет страницы» → «Выровнять» или вручную с помощью линейки. Для массовой корректировки используйте макросы: запишите действия по выравниванию одного абзаца и примените ко всем через «Макросы» → «Выполнить». Если проблема в исходном скане, пересканируйте документ с выравниванием по краям или используйте ScanTailor для автоматической обрезки и выравнивания.
Потеря форматирования (жирный шрифт, курсив, таблицы) после OCR – распространенная проблема. В Word восстановите стили вручную через «Главная» → «Стили» или используйте расширенные OCR-инструменты типа ABBYY FineReader, которые сохраняют исходное форматирование. Для таблиц выделите область скана и примените «Вставка» → «Таблица» → «Преобразовать текст в таблицу». Если таблица сложная, проще перерисовать ее в Word или экспортировать из FineReader в формате .docx с сохранением структуры.
Вопрос-ответ:
Можно ли редактировать отсканированный текст в Word без дополнительных программ, или обязательно нужен OCR?
Да, в Word можно работать с отсканированными документами без сторонних программ, но с ограничениями. Если скан сохранён как изображение (например, в формате JPG или PNG), Word распознает его как картинку — текст редактировать не получится, можно только обрезать, повернуть или добавить подписи. Чтобы редактировать текст напрямую, нужен OCR (распознавание символов). Встроенный инструмент Word для этого — «Преобразовать в текст» (доступен через контекстное меню при выделении изображения). Однако качество распознавания зависит от чёткости скана: размытые или рукописные тексты могут обрабатываться с ошибками. Для сложных случаев лучше использовать специализированные программы вроде ABBYY FineReader, которые точнее распознают шрифты, таблицы и форматирование.

 Загрузка...