Содержание статьи
В системах Linux поиск файлов – это не вспомогательная задача, а регулярная часть администрирования, разработки и сопровождения серверов. Логи приложений, конфигурационные файлы, резервные копии и временные данные могут располагаться в разных каталогах, иметь нестандартные имена и отличаться по правам доступа. Без уверенного владения встроенными инструментами поиск быстро превращается в ручной перебор каталогов и потерю времени.
Linux предоставляет несколько специализированных утилит для решения разных задач поиска. Команда find позволяет выполнять обход файловой системы с учетом имени, размера, типа файла, даты изменения и владельца. locate опирается на индекс и подходит для мгновенного поиска известных путей. grep используется, когда требуется найти конкретное содержимое внутри файлов, включая логи и исходный код. Каждая из этих команд решает свою прикладную задачу и часто применяется в связке с другими инструментами оболочки.
Грамотное использование параметров поиска помогает находить нужные файлы даже на загруженных серверах с миллионами объектов. Например, фильтрация по времени изменения упрощает анализ инцидентов, а поиск по владельцу – аудит прав доступа. В статье рассматриваются практические сценарии применения основных команд поиска в Linux с наглядными примерами, которые можно сразу использовать в рабочей среде.
Поиск файлов в Linux: команды и примеры
Для поиска файлов в Linux используется несколько базовых команд, каждая из которых ориентирована на конкретный сценарий. find выполняет рекурсивный обход каталогов и подходит для точной фильтрации по имени, расширению, типу файла, размеру и времени изменения. Например, поиск всех файлов с расширением .conf в каталоге /etc позволяет быстро выявить конфигурации, задействованные в настройке сервисов.
Команда locate работает на основе предварительно созданной базы данных и возвращает результаты практически мгновенно. Она полезна, когда требуется определить расположение бинарного файла, библиотеки или документа, путь к которому неизвестен. Перед использованием необходимо учитывать актуальность базы, так как новые или удалённые файлы могут не отображаться без обновления индекса.
Когда задача связана не с именами файлов, а с их содержимым, применяется grep. Эта утилита ищет строки по шаблону внутри текстовых файлов и журналов. В административной практике grep используют для анализа логов веб-серверов, поиска ошибок запуска служб и выявления параметров в конфигурациях. Совмещение grep с find позволяет ограничить поиск определённым типом файлов или каталогом.
Дополнительные параметры поиска позволяют учитывать владельца файла, группу и права доступа. Это востребовано при проверке безопасности и диагностике проблем с запуском приложений. Например, поиск файлов без владельца или с правами записи для всех пользователей помогает обнаружить потенциально уязвимые элементы файловой системы.
Поиск файлов по имени с помощью команды find
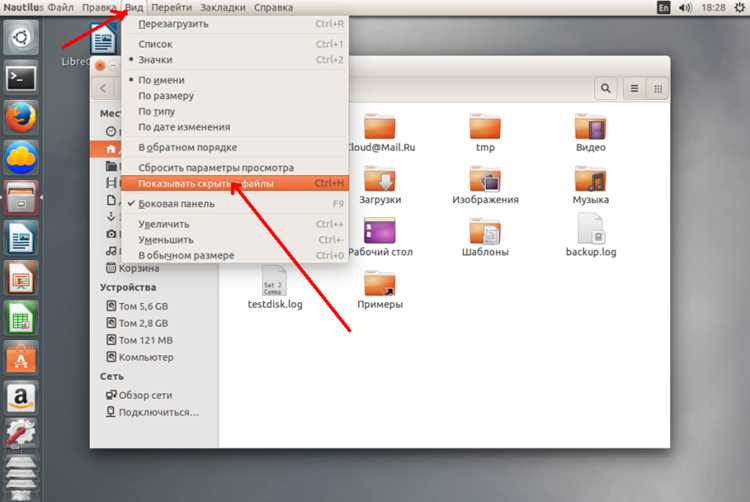
Команда find выполняет рекурсивный обход каталогов и позволяет находить файлы по имени с высокой точностью. Базовый синтаксис включает указание стартового каталога и параметр -name, который сравнивает имя файла с заданным шаблоном. Например, поиск файла nginx.conf во всей файловой системе выполняется от корня, при этом следует учитывать права доступа и нагрузку на диск.
Для учета регистра символов применяется ключ -iname, что удобно при работе с файловыми системами, чувствительными к регистру. Это позволяет находить файлы с одинаковым именем, но разным написанием, например Readme и README, без дублирования запросов.
При работе с большими каталогами целесообразно заранее ограничивать глубину поиска с помощью -maxdepth. Это снижает количество проверяемых объектов и ускоряет выполнение команды. Такой подход полезен при анализе пользовательских директорий или каталогов приложений, где структура заранее известна.
Использование locate для быстрого поиска по базе файлов
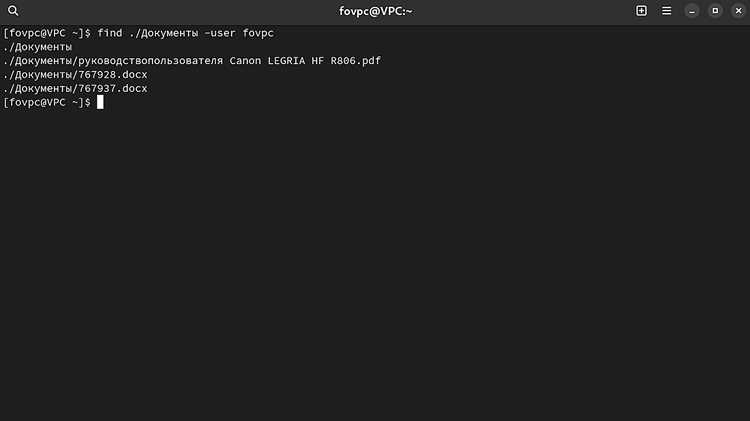
Команда locate выполняет поиск файлов не путем обхода каталогов, а через заранее сформированную базу данных. Благодаря этому результат возвращается мгновенно даже на системах с большим количеством файлов. locate подходит для определения путей к исполняемым файлам, библиотекам и конфигурациям, если известно полное или частичное имя объекта.
Поиск осуществляется по подстроке, поэтому ввод части имени уже дает список совпадений. Для снижения количества результатов рекомендуется указывать уникальные фрагменты имени или применять параметры фильтрации. В отличие от find, locate не проверяет текущие права доступа и может отображать файлы, недоступные для чтения пользователю.
| Команда | Назначение |
|---|---|
| locate имя_файла | Поиск всех путей, содержащих указанную строку |
| locate -i имя_файла | Игнорирование регистра символов |
| locate -n 10 имя_файла | |
| updatedb | Ручное обновление базы данных файлов |
locate не подходит для поиска по атрибутам файла или содержимому, но при работе с известными именами позволяет сократить время поиска до минимума и быстро перейти к нужному пути.
Поиск файлов по размеру, типу и дате изменения
Команда find поддерживает фильтрацию файлов по техническим характеристикам, что позволяет быстро выявлять объекты, влияющие на заполнение диска или связанные с недавними изменениями. Для этого используются отдельные параметры, которые можно комбинировать в одном запросе.
Поиск по размеру применяется при анализе свободного места и обнаружении крупных файлов. Параметр -size принимает значения в блоках, килобайтах, мегабайтах и гигабайтах. Часто используемые варианты:
- поиск файлов больше заданного размера (например, архивов и дампов)
- выявление файлов нулевого размера
- анализ каталогов с нестандартно большими объектами
Фильтрация по типу файла позволяет отделить обычные файлы от каталогов, символических ссылок и устройств. Это удобно при обслуживании серверов и очистке временных данных. На практике применяются следующие типы:
- обычные файлы для анализа логов и документов
- каталоги для проверки структуры проекта
- символические ссылки для поиска некорректных путей
Поиск по дате изменения используется при расследовании инцидентов и проверке обновлений. Параметры времени позволяют находить файлы:
- изменённые за последние сутки или часы
- не изменявшиеся длительное время
- созданные или обновлённые в определённый период
Совмещение условий по размеру, типу и времени изменения помогает сузить выборку до минимального набора файлов, что особенно важно при работе с большими файловыми системами и резервными копиями.
Поиск текста внутри файлов с помощью grep
Для рекурсивного поиска по каталогам применяется ключ -r, позволяющий проверять все вложенные файлы без ручного перечисления путей. При работе с большими журналами полезен параметр -n, который добавляет номера строк и ускоряет навигацию по результатам. Игнорирование регистра символов задаётся опцией -i.
grep поддерживает регулярные выражения, что даёт возможность искать сложные шаблоны, включая IP-адреса, даты и идентификаторы запросов. Это востребовано при разборе логов веб-серверов и систем мониторинга, где требуется выделить конкретные события среди тысяч строк.
Комбинирование find и grep для сложных запросов
Совместное использование find и grep позволяет сначала сузить набор файлов по атрибутам, а затем выполнить поиск по содержимому только в релевантных объектах. Такой подход снижает количество проверяемых файлов и упрощает анализ результатов, особенно в каталогах с большим числом данных.
Типичный сценарий – поиск строк в файлах определённого типа. find отбирает файлы по имени или расширению, после чего передаёт их в grep для проверки содержимого. Это применяется при анализе логов приложений, когда требуется найти сообщения об ошибках только в журналах за конкретный период.
Ограничение по размеру и времени изменения дополнительно сокращает выборку. Например, имеет смысл анализировать только файлы, изменённые за последние сутки или превышающие заданный объём. В результате grep обрабатывает минимальный набор данных, что особенно важно при работе на сервере под нагрузкой.
Комбинация команд используется и для аудита конфигураций. find позволяет исключить временные каталоги и резервные копии, а grep – выявить параметры, влияющие на поведение сервисов. Такой метод подходит для поиска устаревших настроек, дублирующихся значений и некорректных путей.
Поиск файлов с учетом прав доступа и владельца
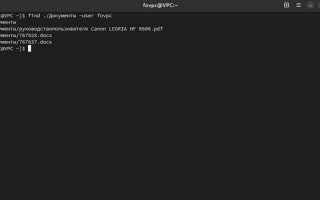
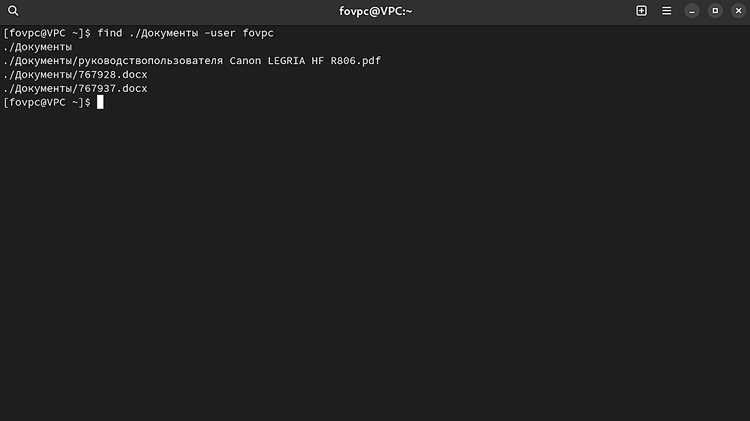
Команда find позволяет находить файлы с учетом владельца, группы и установленных прав доступа, что используется при администрировании многопользовательских систем и проверке безопасности. Для фильтрации по владельцу применяется параметр -user, который помогает выявлять файлы, принадлежащие конкретному аккаунту или оставшиеся после удаления пользователя.
Поиск по группе выполняется с помощью параметра -group. Это востребовано при анализе общих каталогов и сервисных данных, где доступ предоставляется через групповые права. Такой подход позволяет быстро проверить, какие файлы доступны определённой группе пользователей.
Фильтрация по правам доступа осуществляется параметром -perm. Он используется для поиска файлов с разрешением на запись или выполнение для всех пользователей, а также для выявления объектов с установленным битом SUID или SGID. Это важно при обнаружении потенциально опасных файлов в системных каталогах.
Дополнительно find позволяет находить файлы без владельца или группы, что обычно указывает на ошибки обслуживания файловой системы. Такие объекты могут создавать проблемы при резервном копировании и обновлении системы, поэтому их обнаружение и корректировка прав доступа являются обязательной частью регулярного аудита.
Комбинирование условий по владельцу, группе и правам доступа помогает сформировать точный список файлов, требующих внимания, и избежать ручной проверки больших каталогов.
Вопрос-ответ:
Почему команда find ищет файлы медленно и как сократить время выполнения?
find просматривает файловую систему напрямую, поэтому скорость зависит от количества каталогов и файлов. Для ускорения стоит ограничивать начальный каталог, использовать параметры -maxdepth и -type, а также избегать поиска от корня без необходимости. При регулярных поисках по имени имеет смысл применять locate, так как он не выполняет обход в реальном времени.
Почему locate не находит файл, который был создан несколько минут назад?
locate использует индекс файловой системы, который обновляется по расписанию. Если файл создан после последнего обновления базы, он не появится в результатах. В такой ситуации нужно обновить индекс вручную с помощью updatedb или воспользоваться find для немедленного поиска.
Как найти строку в логах только за последние сутки?
Сначала следует отобрать файлы, изменённые за нужный период, с помощью find и параметра -mtime, а затем передать их в grep. Такой подход позволяет исключить старые логи и сократить объём обрабатываемых данных, что особенно полезно при разборе ошибок на сервере.
Чем отличается поиск по -name и -iname в find?
-name учитывает регистр символов и ищет точное совпадение по шаблону. -iname игнорирует регистр, поэтому подходит для ситуаций, когда неизвестно точное написание имени файла. Это часто применяется при работе с пользовательскими каталогами и сторонними архивами.
Как обнаружить файлы с небезопасными правами доступа?
Для этого используется find с параметром -perm. С его помощью можно выявить файлы, доступные для записи всем пользователям, а также объекты с установленными SUID или SGID. Такие файлы требуют проверки, так как они могут привести к несанкционированному выполнению команд.
Как найти файлы с одинаковыми именами в разных каталогах?
Для этого используется find с указанием общего шаблона имени и стартового каталога. Команда выполнит рекурсивный поиск и выведет все совпадения с полным путём. Такой подход удобен при проверке дублирующихся конфигураций или скриптов, которые могут находиться в пользовательских и системных каталогах одновременно.
Почему grep выводит двоичные файлы и как этого избежать?
grep по умолчанию пытается обработать любой файл, переданный ему на вход. Если среди них есть двоичные данные, вывод становится нечитаемым. Для исключения таких файлов применяются параметры, ограничивающие поиск только текстовыми форматами, либо предварительный отбор файлов через find по расширению и типу.

 Загрузка...