Содержание статьи
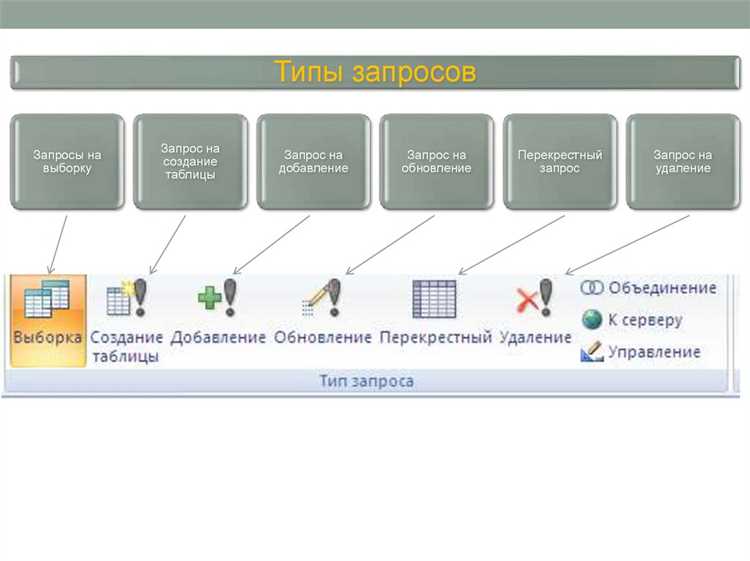
Операторы запросов – это не абстрактный синтаксис, а практический инструмент управления данными на уровне строк, столбцов и связей между таблицами. Именно они определяют, какие данные будут извлечены, изменены или удалены, в каком объёме и с какими условиями. Понимание различий между SELECT, INSERT, UPDATE и DELETE позволяет не только получать нужные результаты, но и напрямую влиять на производительность базы данных и целостность информации.
Ключевую роль в реальных проектах играют операторы фильтрации и логики: WHERE, AND, OR, IN, BETWEEN, LIKE. Неправильно сформированное условие может привести к полному сканированию таблицы даже при наличии индексов. Практическая рекомендация – всегда проверять, какие поля участвуют в условиях отбора, и сопоставлять их с индексами, особенно при работе с таблицами объёмом от сотен тысяч записей.
Операторы объединения данных (JOIN, LEFT JOIN, RIGHT JOIN, INNER JOIN) определяют логику связей между сущностями. Ошибка на этом уровне часто приводит не к сбою, а к логически неверному результату, который сложнее обнаружить. Для надёжных запросов важно явно указывать условия соединения и избегать неявных связей, особенно при работе с несколькими таблицами, содержащими одноимённые поля.
Отдельного внимания заслуживают операторы агрегации: COUNT, SUM, AVG, MIN, MAX в сочетании с GROUP BY и HAVING. Они используются для аналитики и отчётности, но требуют аккуратного подхода: добавление лишнего поля в группировку может радикально изменить результат. Оптимальная практика – сначала формировать базовый набор данных, а затем применять агрегацию как отдельный логический шаг.
Грамотное использование операторов запросов – это баланс между читаемостью, точностью и скоростью выполнения. Чем сложнее бизнес-логика, тем важнее структурировать запросы, избегать дублирования условий и проверять их через план выполнения. Такой подход снижает нагрузку на базу данных и упрощает дальнейшую поддержку кода.
Как оператор SELECT выбирает нужные столбцы и выражения
Оператор SELECT формирует результирующий набор данных на основе списка выбираемых элементов, указанных сразу после ключевого слова SELECT. Каждый элемент может быть именем столбца, выражением, агрегатной функцией или результатом вычислений. Порядок перечисления элементов напрямую определяет структуру и последовательность столбцов в результате запроса.
При выборе конкретных столбцов SELECT обращается к схеме таблицы и извлекает значения только указанных полей. Использование явных имён столбцов предпочтительнее символа *, так как снижает объём передаваемых данных, ускоряет выполнение запроса и предотвращает ошибки при изменении структуры таблицы.
SELECT поддерживает вычисляемые выражения: арифметические операции, конкатенацию строк, работу с датами и логические преобразования. Например, можно объединять несколько столбцов в одно значение или вычислять производные показатели на лету. Такие выражения обрабатываются для каждой строки результата до применения сортировки и ограничения выборки.
Для повышения читаемости и дальнейшей обработки результата используются псевдонимы, задаваемые с помощью ключевого слова AS. Псевдонимы особенно важны при работе с выражениями и агрегатами, так как позволяют явно определить имя выходного столбца и использовать его во внешних запросах.
Агрегатные функции (COUNT, SUM, AVG, MIN, MAX) в SELECT изменяют логику выборки: они обрабатывают набор строк, а не отдельные значения. При их использовании оператор SELECT выбирает не конкретные столбцы, а результаты агрегации, что требует согласованности с предложением GROUP BY.
SELECT также позволяет включать в список выбираемых элементов подзапросы, возвращающие скалярное значение. Такие подзапросы выполняются отдельно для каждой строки основного результата, что следует учитывать из-за возможных затрат производительности.
Грамотный выбор столбцов и выражений в SELECT обеспечивает точность данных, снижает нагрузку на базу и делает запросы предсказуемыми при масштабировании и сопровождении.
Как WHERE задаёт условия отбора строк
Оператор WHERE применяется для фильтрации строк на этапе выполнения запроса и напрямую влияет на объём данных, возвращаемых сервером базы данных. Он обрабатывается после FROM и до GROUP BY, HAVING и ORDER BY, поэтому именно через него задаётся первичная логика отбора записей.
Условия в WHERE формируются с использованием операторов сравнения (=, <>, >, <, >=, <=), логических операторов (AND, OR, NOT) и специальных конструкций. Например, выражение WHERE price > 1000 AND status = ‘active’ исключает строки, не удовлетворяющие обоим критериям, что сокращает объём обрабатываемых данных ещё до этапа агрегации.
Для работы с диапазонами применяется BETWEEN, который включает граничные значения. Запрос WHERE created_at BETWEEN ‘2024-01-01’ AND ‘2024-12-31’ отбирает строки строго в пределах указанного периода без необходимости писать два отдельных сравнения.
Оператор IN используется для проверки вхождения значения в заданный набор. WHERE category_id IN (3, 5, 8) читается и оптимизируется проще, чем цепочка условий с OR, и позволяет базе данных эффективнее использовать индексы.
Для обработки отсутствующих значений применяется IS NULL и IS NOT NULL. Сравнение с NULL через знак равенства не работает, поэтому WHERE deleted_at IS NULL является единственным корректным способом отбора актуальных записей.
Шаблонный поиск выполняется через LIKE с символами подстановки. Знак % заменяет любую последовательность символов, а _. Условие WHERE email LIKE ‘%@example.com’ отбирает все адреса домена, но при этом может игнорировать индекс, если шаблон начинается с %.
WHERE поддерживает вложенные подзапросы, позволяя задавать зависимые условия. Например, WHERE user_id IN (SELECT id FROM users WHERE role = ‘admin’) ограничивает выборку строками, связанными с конкретным набором данных из другой таблицы.
Для повышения производительности рекомендуется формулировать условия так, чтобы они могли использовать индексы: избегать функций над индексируемыми столбцами, не смешивать разные типы данных в сравнении и минимизировать использование OR при больших выборках.
Как использовать INNER JOIN для объединения связанных таблиц
INNER JOIN применяется для выборки строк, имеющих совпадения по заданному условию в обеих таблицах. Он отбрасывает записи без соответствия, что делает его оптимальным для работы с нормализованными схемами, где связи заданы внешними ключами.
Базовый синтаксис строится вокруг условия соединения, которое должно опираться на индексируемые поля:
SELECT поля FROM таблица_1 INNER JOIN таблица_2 ON таблица_1.id = таблица_2.fk_id
Для корректного и быстрого выполнения запроса важно учитывать следующие рекомендации:
- Используй явное указание
INNER JOINвместо соединения черезWHERE– это улучшает читаемость и снижает риск логических ошибок. - Соединяй таблицы по первичному и внешнему ключу одинакового типа данных, включая длину и знак чисел.
- Убеждайся, что поля в условии
ONпроиндексированы, иначе соединение больших таблиц приведет к полному сканированию.
При работе с несколькими таблицами порядок соединений имеет значение для оптимизатора, особенно в сложных запросах:
FROM заказы INNER JOIN клиенты ON заказы.client_id = клиенты.id INNER JOIN статусы ON заказы.status_id = статусы.id
В таких запросах рекомендуется:
- Начинать с таблицы с наименьшим объемом данных или с наиболее селективными условиями.
- Использовать псевдонимы таблиц для сокращения имен и устранения неоднозначностей.
- Выносить фильтрацию, не связанную с соединением, в
WHERE, а не вON.
INNER JOIN не подходит, если требуется сохранить строки без соответствий. В таких случаях следует выбирать внешние соединения. Для аналитических и отчетных запросов INNER JOIN обеспечивает точные результаты без дополнительных проверок на NULL, упрощая дальнейшую обработку данных.
Когда применять LEFT JOIN для получения неполных связей
Типичный случай – учет сущностей, которые могут не иметь подчинённых записей. Например, список пользователей с их последним заказом: пользователи без заказов должны присутствовать в выборке, а значения полей заказа будут равны NULL. INNER JOIN в такой ситуации исказит данные, исключив этих пользователей полностью.
LEFT JOIN оправдан при построении отчетов контроля полноты данных. Если необходимо выявить, какие записи не имеют связей (например, товары без категории или счета без платежей), условие WHERE с проверкой на NULL по полям правой таблицы позволяет точно отфильтровать такие случаи.
При проектировании запросов важно переносить условия фильтрации, относящиеся к правой таблице, в секцию ON. Размещение их в WHERE превращает LEFT JOIN в фактический INNER JOIN и уничтожает смысл получения неполных связей. Это распространённая ошибка при оптимизации запросов.
LEFT JOIN целесообразен и при инкрементальной загрузке данных, когда правая таблица наполняется с задержкой. Запросы остаются стабильными и не требуют переписывания логики по мере появления связанных записей.
| Сценарий | Причина использования LEFT JOIN |
| Отчёты по пользователям | Сохранение пользователей без активности |
| Контроль качества данных | Выявление отсутствующих связей через NULL |
| Временные разрывы данных | Корректная работа при неполной загрузке |
Использовать LEFT JOIN не стоит в транзакционных запросах, где отсутствие связи означает логическую ошибку. В таких случаях INNER JOIN быстрее и точнее отражает бизнес-ограничения.
Как GROUP BY формирует группы для агрегатных функций
Оператор GROUP BY объединяет строки таблицы на основе значений указанных колонок. Каждое уникальное сочетание значений становится отдельной группой, для которой затем вычисляются агрегатные функции, такие как COUNT, SUM, AVG, MIN и MAX. Если указано несколько колонок, формируются комбинированные группы: каждая комбинация уникальных значений колонок рассматривается отдельно.
При использовании GROUP BY следует учитывать порядок указания колонок. SQL сначала группирует по первой колонке, затем внутри каждой группы создаёт подгруппы по второй, и так далее. Это влияет на результат агрегатных функций: например, SUM будет вычисляться отдельно для каждой подгруппы.
Для корректного применения агрегатных функций необходимо включать в SELECT только агрегированные поля или те колонки, которые участвуют в GROUP BY. Любая попытка вывести колонку вне этих условий приведёт к ошибке или некорректному результату.
Оптимизация запросов с GROUP BY требует анализа индексов. Наличие индекса на колонках группировки ускоряет формирование групп, снижает нагрузку на сервер и уменьшает время выполнения агрегатных функций на больших объёмах данных.
Для сложных случаев можно использовать выражения внутри GROUP BY, включая функции и арифметические операции. Это позволяет группировать по результату вычислений, например, по месяцу даты или округлённому значению числового поля, создавая более гибкие и аналитически значимые группы.
GROUP BY также совместим с фильтрацией после группировки через HAVING. В отличие от WHERE, который фильтрует строки до группировки, HAVING позволяет отбрасывать группы на основе значений агрегатных функций, обеспечивая точный контроль над итоговым результатом.
Практическое применение требует проверки результатов на тестовых данных, особенно при комбинировании нескольких агрегатных функций. Это предотвращает ошибки из-за некорректной группировки и позволяет убедиться, что каждая группа формируется именно так, как ожидается.
Как HAVING фильтрует результаты после группировки
Оператор HAVING применяется после группировки данных с помощью GROUP BY и позволяет фильтровать агрегированные результаты, а не отдельные строки таблицы. Он работает только с агрегатными функциями: SUM(), COUNT(), AVG(), MIN(), MAX().
Основные принципы работы HAVING:
- Фильтрация происходит после формирования групп.
- Условия могут использовать агрегатные функции для отбора групп по сумме, среднему или количеству элементов.
- Можно комбинировать с WHERE: WHERE отбирает строки до группировки, HAVING – группы после.
Примеры применения:
- Выбор клиентов с суммарной покупкой выше 1000 единиц:
SELECT client_id, SUM(amount) AS total FROM orders GROUP BY client_id HAVING SUM(amount) > 1000; - Подсчет категорий товаров с более чем 50 продажами:
SELECT category_id, COUNT(*) AS sales_count FROM products GROUP BY category_id HAVING COUNT(*) > 50; - Определение сотрудников, средняя зарплата которых превышает 70 000:
SELECT department_id, AVG(salary) AS avg_salary FROM employees GROUP BY department_id HAVING AVG(salary) > 70000;
Рекомендации при использовании HAVING:
- Использовать WHERE для фильтрации строк до группировки – это снижает нагрузку на сервер.
- Стараться избегать сложных вычислений внутри HAVING – лучше использовать подзапросы или предварительные агрегаты.
- При больших данных проверять индексы по полям, используемым в GROUP BY, чтобы ускорить обработку.
- HAVING не заменяет WHERE: ошибки часто возникают при попытке использовать агрегатные функции в WHERE.
Таким образом, HAVING эффективно фильтрует только агрегированные группы и позволяет строить точные отчеты на основе сумм, средних, минимумов и максимумов, обеспечивая контроль над результатами после группировки.
Как ORDER BY управляет сортировкой результатов запроса
Оператор ORDER BY задает порядок отображения строк в результате SQL-запроса. По умолчанию сортировка выполняется по возрастанию (ASC), но явное указание DESC позволяет отсортировать данные по убыванию. Например, `ORDER BY дата DESC` гарантирует, что последние записи будут первыми.
ORDER BY может принимать несколько столбцов для многоуровневой сортировки. При использовании `ORDER BY фамилия ASC, имя ASC` строки сначала упорядочиваются по фамилии, а при совпадении фамилий – по имени. Порядок перечисления столбцов критичен и влияет на финальный результат.
Важно учитывать тип данных столбца. Для чисел сортировка точна и предсказуема, а для строк она зависит от колlation базы данных, что влияет на регистр, локализацию и специальные символы. Например, ‘Алексей’ может идти после ‘александр’, если collation чувствителен к регистру.
Использование индексов ускоряет сортировку. При запросе `SELECT * FROM таблица ORDER BY дата` наличие индекса по полю дата уменьшает объем операций сортировки, особенно на больших объемах данных. Без индекса база данных выполняет полное сканирование и сортировку всех строк в памяти.
ORDER BY совместим с агрегатными функциями и подзапросами. Например, `SELECT * FROM (SELECT * FROM таблица WHERE сумма>100) AS t ORDER BY сумма DESC` сначала фильтрует данные, а затем сортирует их по сумме, обеспечивая точный контроль над последовательностью результатов.
Не рекомендуется использовать ORDER BY без LIMIT на таблицах с миллионами строк, так как сортировка всего набора может существенно замедлить выполнение запроса. В таких случаях целесообразно ограничивать выборку и использовать индексы для оптимизации.
ORDER BY можно комбинировать с вычисляемыми выражениями. Пример: `ORDER BY год(дата) ASC, месяц(дата) DESC` позволяет группировать данные по году и внутри каждого года сортировать по убыванию месяца, что удобно для отчетов по временным периодам.
При сортировке NULL значений их поведение зависит от СУБД. В PostgreSQL и Oracle по умолчанию NULL считаются наибольшими, в MySQL – наименьшими. Для контроля используется `ORDER BY поле ASC NULLS FIRST` или `NULLS LAST`, что гарантирует предсказуемую последовательность при наличии пустых значений.
Оператор LIMIT задаёт точное количество строк, возвращаемых запросом. Например, `LIMIT 20` гарантирует, что результат не превысит 20 записей, независимо от общего объёма таблицы.
Пример использования для третьей страницы при размере страницы 10: `LIMIT 10 OFFSET 20`. Здесь LIMIT 10 задаёт количество строк на странице, OFFSET 20 пропускает две предыдущие страницы (по 10 записей каждая).
OFFSET увеличивает нагрузку на сервер при больших смещениях, так как СУБД сначала просматривает пропущенные строки. Для больших таблиц эффективнее использовать ключевые значения последней записи предыдущей страницы в условии WHERE вместо большого OFFSET.
LIMIT и OFFSET применимы не только в SELECT, но и в подзапросах, когда требуется ограничить объём данных перед объединением с другими таблицами. Это позволяет уменьшить память и ускорить выполнение сложных запросов.
Для динамических интерфейсов рекомендуется вычислять OFFSET на основе номера страницы: `OFFSET = (page_number — 1) * page_size`. Такой подход упрощает реализацию пагинации на клиентской стороне и обеспечивает корректное отображение страниц при изменении размера выборки.
Использование LIMIT с небольшими значениями уменьшает сетевую нагрузку и ускоряет отклик, особенно при работе с веб-приложениями и мобильными клиентами, где передача больших наборов данных нежелательна.
Вопрос-ответ:
Какая разница между оператором SELECT и оператором INSERT?
Оператор SELECT используется для извлечения данных из таблиц базы данных и позволяет выбирать определённые поля или строки по заданным условиям. INSERT, наоборот, добавляет новые записи в таблицу. То есть SELECT работает с уже существующей информацией, а INSERT создаёт новые данные. Кроме того, SELECT может быть дополнен условиями фильтрации и сортировки, а INSERT требует точного указания значений для каждого поля, если не используются значения по умолчанию.
Как оператор UPDATE изменяет данные в таблице и есть ли риски при его использовании?
Оператор UPDATE позволяет изменять существующие записи в таблице по определённым условиям. Основной риск связан с отсутствием точного фильтра: если WHERE не указан или задан некорректно, обновление может затронуть все строки таблицы. Чтобы избежать ошибок, обычно используют уточнённые условия и сначала проверяют, какие записи будут затронуты через SELECT с теми же критериями.
Что делает оператор DELETE и чем он отличается от TRUNCATE?
Оператор DELETE удаляет записи из таблицы по заданным условиям, оставляя структуру таблицы и возможность отката изменений через транзакцию. TRUNCATE же полностью очищает таблицу, удаляя все строки без возможности отката стандартными средствами SQL и обычно работает быстрее, так как не фиксирует удаление каждой строки отдельно. DELETE позволяет избирательно удалять данные, TRUNCATE — нет.
Для чего используется оператор JOIN и какие типы соединений бывают?
Оператор JOIN объединяет данные из двух и более таблиц на основе связанных столбцов, позволяя получать объединённые результаты без дублирования информации. Существуют разные типы соединений: INNER JOIN возвращает только совпадающие записи, LEFT JOIN включает все строки из левой таблицы и совпадающие из правой, RIGHT JOIN — наоборот, а FULL OUTER JOIN возвращает все записи из обеих таблиц с NULL там, где совпадений нет. Выбор типа соединения зависит от того, какие данные нужны для анализа.
Как фильтруются данные с помощью оператора WHERE и какие ограничения есть на его использование?
Оператор WHERE используется для выбора только тех строк, которые удовлетворяют заданному условию. Он может работать с разными типами выражений: равенство, диапазоны, подзапросы и логические операторы. Ограничение в том, что условие должно ссылаться на существующие столбцы и правильно учитывать тип данных; некорректное выражение вызовет ошибку. Кроме того, WHERE нельзя использовать для фильтрации агрегированных значений напрямую — для этого применяют HAVING после группировки.
Для чего используются операторы при работе с базой данных?
Операторы позволяют формировать запросы, которые выбирают, фильтруют, изменяют или удаляют данные в таблицах базы данных. С их помощью можно, например, получать записи по определённым условиям, объединять несколько таблиц, сортировать результаты или изменять конкретные значения в таблицах. Они являются инструментом управления данными без необходимости ручного поиска и редактирования каждой записи.

 Загрузка...