Содержание статьи
Виртуальный помощник может выполнять конкретные задачи: отправку уведомлений, управление календарем, обработку запросов пользователей и интеграцию с внешними сервисами. Перед началом разработки важно составить точный список функций и определить приоритетные сценарии использования, чтобы сосредоточиться на реально востребованных возможностях.
Выбор платформы напрямую влияет на скорость разработки и возможности масштабирования. Для текстовых помощников подходят Python с библиотеками Rasa или Dialogflow, а для голосовых – Alexa Skills Kit или Google Actions. Решение о платформе должно учитывать тип пользователей, количество одновременных запросов и требования к безопасности данных.
Структура диалогов и сценариев должна строиться вокруг конкретных пользовательских запросов. Создайте карту интерактивных сценариев, включая варианты ошибок и уточняющих вопросов. Такой подход снижает риск некорректных ответов и повышает точность обработки естественного языка.
Непосредственная настройка NLP включает выбор модели, токенизацию и классификацию намерений. Для русского языка рекомендуется использовать DeepPavlov или ruBERT, а также тестировать модели на собственных наборах данных, чтобы повысить точность распознавания специфических запросов.
Интеграция с API позволяет автоматизировать выполнение задач: отправку писем, доступ к CRM или работу с базами данных. Настройка надежных соединений и обработка ошибок на уровне кода обеспечивает стабильную работу помощника даже при сбоях внешних сервисов.
Создание виртуального помощника: пошаговое руководство
Первый шаг – определить конкретные задачи помощника. Составьте список действий, которые он должен выполнять: управление календарем, уведомления, поиск информации, работа с файлами и интеграция с внешними сервисами. Каждую задачу стоит разбить на отдельные подзадачи, чтобы легче было реализовать и тестировать функционал.
Следующий этап – выбор инструментов и платформы. Для текстовых помощников подходят Python с библиотеками Rasa или Dialogflow, для голосовых – Alexa Skills Kit или Google Actions. Оцените потребление ресурсов, возможности масштабирования и поддержку русского языка при выборе платформы.
Проектирование структуры диалогов требует построения карты сценариев, включающей вопросы пользователей и варианты ответов. Включите обработку ошибок и уточняющих запросов, чтобы снизить количество некорректных ответов и повысить точность понимания намерений пользователя.
Настройка обработки естественного языка (NLP) начинается с выбора модели и токенизации текстов. Для русского языка рекомендуется использовать DeepPavlov или ruBERT. Обучение на собственных данных помогает адаптировать модель к специфическим запросам и улучшить распознавание сложных конструкций.
Интеграция с внешними сервисами выполняется через API. Подключите почтовые сервисы, CRM, базы данных и мессенджеры. Продумайте обработку ошибок и логирование, чтобы помощник корректно реагировал на сбои и сохранял непрерывность работы.
После реализации основных функций необходимо провести тестирование. Используйте автоматические и ручные сценарии, включающие типичные и редкие запросы. Анализируйте логи для выявления проблемных мест и оптимизируйте алгоритмы обработки.
Финальный шаг – развертывание и мониторинг. Настройте серверное окружение, системы уведомлений о сбоях и метрики производительности. Регулярно обновляйте модели NLP и сценарии диалогов на основе анализа поведения пользователей, чтобы поддерживать актуальность и точность помощника.
Определение задач и функций виртуального помощника
Перед разработкой необходимо зафиксировать точный перечень функций, которые помощник будет выполнять. Это помогает сфокусировать разработку и уменьшить количество лишнего кода.
Составьте список задач и разложите их на конкретные действия:
- Управление расписанием: создание, редактирование и удаление событий, напоминания о встречах, синхронизация с календарями Google или Outlook.
- Работа с уведомлениями: отправка сообщений в мессенджеры, уведомления по электронной почте, SMS-уведомления.
- Обработка запросов пользователей: поиск информации в базе данных, ответы на часто задаваемые вопросы, формирование отчетов.
- Интеграция с внешними сервисами: подключение CRM, бухгалтерских систем, облачных хранилищ.
- Автоматизация рутинных задач: сортировка писем, создание шаблонов сообщений, обработка форм и документов.
Для каждой задачи важно определить:
- Приоритет выполнения: какие функции критичны для пользователя, какие могут быть добавлены позже.
- Формат взаимодействия: текстовый, голосовой или комбинированный.
- Требования к данным: какие данные нужны для выполнения задачи, как их безопасно хранить и обрабатывать.
После составления списка задач можно перейти к проектированию диалогов и выбору инструментов разработки, основываясь на четко определенном функционале.
Выбор платформы и инструментов для разработки
Выбор платформы зависит от типа виртуального помощника и объема задач. Для текстовых помощников подходят Python с библиотеками Rasa, Dialogflow или Botpress. Для голосовых решений оптимальны Alexa Skills Kit и Google Actions. Оцените возможность интеграции с русскоязычными NLP-моделями и требуемое количество одновременных подключений.
Инструменты разработки делятся на несколько категорий:
- Фреймворки для NLP: DeepPavlov, ruBERT, spaCy с русской локализацией.
- Средства для построения диалогов: визуальные редакторы Rasa X или Dialogflow Console позволяют быстро создавать и тестировать сценарии.
- Интеграционные инструменты: REST API, Webhooks, SDK для мессенджеров и CRM.
- Средства тестирования: unittest, pytest для Python, инструменты симуляции диалогов внутри платформы.
При выборе платформы учитывайте требования к хранению данных и безопасности. Локальные решения удобны для конфиденциальных данных, облачные сервисы обеспечивают масштабируемость и быструю интеграцию с внешними системами.
Рекомендуется начать с одного фреймворка для NLP и одного инструмента для диалогов, постепенно расширяя функционал. Такой подход снижает сложность разработки и позволяет точнее оценивать нагрузку и поведение помощника.
Проектирование структуры диалогов и сценариев общения
Структура диалогов определяется набором сценариев, которые помощник будет обрабатывать. Каждое взаимодействие необходимо разбить на шаги с четким определением возможных пользовательских запросов и ожидаемых ответов.
Основные этапы проектирования:
- Сбор пользовательских запросов: проанализируйте типовые вопросы и команды, которые пользователи могут задавать. Для этого используйте данные из существующих сервисов, FAQ и чатов поддержки.
- Классификация намерений: разбейте запросы на категории, например: поиск информации, управление расписанием, уведомления, интеграция с сервисами.
- Построение ветвлений: для каждого намерения создайте дерево вариантов ответов, включая уточняющие вопросы и обработку ошибок.
- Определение контекста: укажите, какие данные необходимо сохранять между шагами диалога, чтобы поддерживать последовательность общения.
- Обработка нестандартных ситуаций: предусмотрите ответы на непредсказуемые команды, запросы без смысла или пустые сообщения.
Рекомендуется использовать визуальные инструменты, такие как Rasa X или Dialogflow Console, для построения и проверки сценариев. Это позволяет выявлять узкие места в логике диалога и корректировать ветвления до запуска помощника.
Тестирование сценариев должно включать как стандартные запросы, так и редкие комбинации, чтобы проверить устойчивость и точность реакции помощника на неожиданные ситуации.
Настройка обработки естественного языка (NLP)
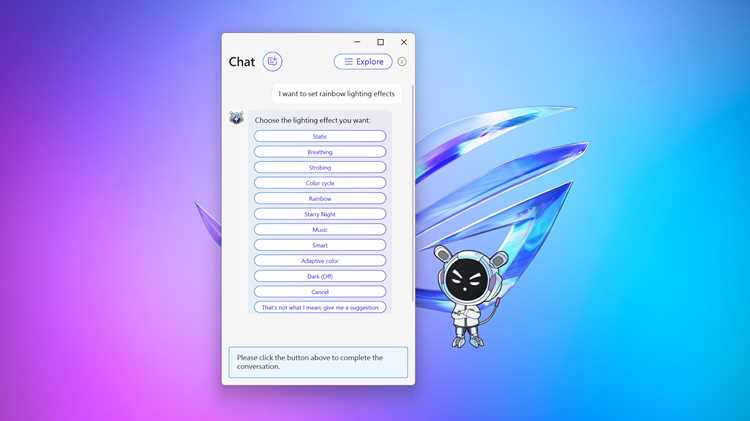
Обработка естественного языка обеспечивает распознавание пользовательских запросов и определение намерений. Для русского языка рекомендуется использовать DeepPavlov, ruBERT или spaCy с русской локализацией. Выбор модели зависит от объема данных и сложности запросов.
Основные этапы настройки NLP:
- Токенизация и нормализация: разбор текста на слова и приведение к базовой форме. Используйте стемминг или лемматизацию для повышения точности классификации.
- Классификация намерений: создайте список категорий запросов и обучите модель на примерах. Для небольших наборов данных подойдут алгоритмы Logistic Regression или Random Forest, для крупных – трансформеры на базе ruBERT.
- Извлечение сущностей: настройте распознавание ключевых элементов запроса, таких как даты, имена, адреса или параметры команд. Это позволяет выполнять задачи с точными параметрами.
- Обработка ошибок и неопределенных запросов: добавьте fallback-ответы и уточняющие вопросы, чтобы минимизировать некорректные действия помощника.
- Обучение на собственных данных: собирайте реальные запросы пользователей и дообучайте модель, чтобы повысить точность в специфических сценариях.
Регулярная проверка метрик точности и полноты распознавания, а также тестирование на новых данных позволяет корректировать модель NLP и снижать количество ошибок при взаимодействии с пользователем.
Интеграция с внешними сервисами и API
Интеграция с внешними сервисами расширяет функционал виртуального помощника и позволяет автоматизировать задачи. Основные типы подключений включают почтовые сервисы, CRM, облачные хранилища и мессенджеры.
Рекомендуется использовать REST API или Webhooks для обмена данными. Для каждого сервиса следует:
- Определить формат данных, поддерживаемый API (JSON, XML).
- Настроить аутентификацию и авторизацию (OAuth 2.0, API-ключи).
- Обработать возможные ошибки соединения и тайм-ауты, чтобы предотвратить сбои в работе помощника.
- Логировать запросы и ответы для последующего анализа и отладки.
Для повышения надежности можно реализовать кэширование данных и повторные попытки запросов при временных сбоях. Важно контролировать лимиты API, чтобы избежать блокировок и перегрузки сервисов.
Тестирование интеграций следует проводить на тестовых учетных записях и с контролем корректности данных. После подтверждения стабильной работы можно подключать реальных пользователей и настраивать мониторинг взаимодействий в реальном времени.
Разработка системы управления данными пользователя
Система управления данными пользователя обеспечивает хранение, обработку и доступ к информации, необходимой для работы виртуального помощника. Основные компоненты включают базы данных, механизмы кэширования и управление сессиями.
Для хранения информации рекомендуется использовать реляционные базы данных, такие как PostgreSQL или MySQL, для структурированных данных и MongoDB для гибких схем и логов взаимодействий. Обязательно предусмотреть шифрование данных на уровне базы и транспортного канала.
Управление сессиями позволяет отслеживать текущие действия пользователя и контекст диалога. Для этого создаются таблицы или коллекции с идентификатором пользователя, временными метками и текущим состоянием диалога. Сессии следует автоматически завершать после определенного времени бездействия.
Кэширование ключевых данных ускоряет работу помощника. Используйте Redis или Memcached для временного хранения часто запрашиваемой информации, например, последних сообщений или результатов поиска.
Необходимо реализовать контроль доступа к данным, разграничение прав чтения и записи для разных модулей системы, а также логирование изменений для последующего анализа и аудита.
Регулярное резервное копирование базы данных и проверка целостности информации позволяют поддерживать непрерывную работу помощника и предотвращать потерю данных при сбоях.
Тестирование и отладка работы помощника
Тестирование виртуального помощника направлено на проверку корректности обработки запросов, стабильности работы и точности NLP-моделей. Для этого создаются сценарии с различными типами запросов: стандартные, редкие и ошибочные.
Для контроля качества удобно использовать таблицу с ключевыми параметрами тестирования:
| Параметр | Описание | Метод проверки |
|---|---|---|
| Точность распознавания намерений | Процент правильно классифицированных запросов пользователя | Сравнение ответов помощника с эталонной разметкой запросов |
| Обработка ошибок | Реакция на неполные, некорректные или неожиданные команды | Ввод ошибочных запросов и анализ fallback-ответов |
| Время отклика | Скорость ответа на запросы пользователей | Замеры времени с использованием логирования или нагрузочного тестирования |
| Интеграция с сервисами | Корректность взаимодействия с внешними API | Проверка всех подключенных сервисов на тестовых данных |
| Сохранение контекста | Правильное ведение диалога в рамках сессии | Проверка последовательности ответов на цепочки запросов |
Для отладки рекомендуется использовать логи запросов и ответов, а также встроенные инструменты платформ, такие как Rasa X или Dialogflow Simulator. Это позволяет выявлять проблемные места в сценариях и корректировать NLP-модель до релиза.
Регулярное тестирование после добавления новых функций или обновления моделей помогает поддерживать стабильность и точность работы помощника при взаимодействии с реальными пользователями.
Запуск и мониторинг производительности в реальном времени
После завершения разработки и тестирования помощник разворачивается на сервере или облачной платформе с поддержкой масштабирования. Для текстовых ботов подходят AWS, Google Cloud или Azure, для голосовых – специализированные облака Alexa или Dialogflow.
Мониторинг в реальном времени включает несколько ключевых показателей:
- Время отклика: измеряется среднее и пиковое время обработки запросов. Целевое значение для текстового помощника – до 500 мс.
- Нагрузка на сервер: использование CPU и RAM, количество одновременных сессий. Настройка авто-масштабирования позволяет выдерживать пики трафика.
- Ошибки и исключения: логирование 4xx и 5xx ошибок, тайм-аутов API и сбойных сценариев. Настройка уведомлений о критических ошибках ускоряет реакцию команды.
- Использование ресурсов NLP: мониторинг потребления GPU/CPU для моделей трансформеров и корректировка batch-size и очередей запросов.
- Взаимодействие с внешними сервисами: контроль статусов API, скорость отклика и корректность возвращаемых данных.
Для визуализации показателей применяются панели мониторинга, такие как Grafana или Prometheus. Настройка алертов позволяет сразу реагировать на аномалии и поддерживать стабильность работы помощника при росте пользовательской активности.
Регулярный анализ логов и метрик помогает выявлять узкие места в сценариях и оптимизировать обработку запросов, повышая точность и скорость взаимодействия с пользователями.
Вопрос-ответ:
Какие задачи стоит включить в функционал виртуального помощника для офиса?
Для офисного помощника рекомендуется реализовать управление календарем и расписанием, отправку уведомлений по электронной почте и в мессенджерах, автоматизацию обработки документов, интеграцию с CRM и облачными хранилищами, а также ответы на часто задаваемые вопросы сотрудников. Каждую функцию стоит разбить на отдельные действия, чтобы легче тестировать и расширять функционал.
Как правильно выбрать платформу для создания помощника с поддержкой русского языка?
При выборе платформы нужно учитывать тип помощника (текстовый или голосовой), нагрузку и требования к интеграции. Для текстовых решений подойдут Python с Rasa, Dialogflow или Botpress, а для голосовых — Alexa Skills Kit или Google Actions. Важно проверить, поддерживает ли выбранная платформа NLP-модели для русского языка, и какие есть возможности для масштабирования и безопасного хранения данных.
Каким образом проектировать сценарии диалогов, чтобы помощник правильно реагировал на разные запросы?
Сценарии диалогов строятся вокруг категорий намерений пользователя. Сначала собираются реальные запросы, затем они классифицируются по типам: поиск информации, управление задачами, уведомления, интеграция с сервисами. Для каждой категории создаются ветвления с основными и уточняющими вопросами, а также обработка некорректных или пустых запросов. Использование визуальных редакторов позволяет проверить логику и выявить узкие места до запуска.
Какие методы тестирования помогают выявить ошибки в работе помощника?
Для проверки работы помощника применяют комбинацию ручного и автоматического тестирования. В ручных сценариях проверяют типовые, редкие и ошибочные запросы, анализируют последовательность диалога и корректность ответов. Автоматизированные тесты используют метрики точности классификации намерений, обработку ошибок, время отклика и корректность работы интеграций с API. Логи и симуляторы диалогов помогают выявлять проблемные участки и корректировать модели NLP.
Как организовать мониторинг производительности помощника после запуска?
Мониторинг включает отслеживание времени отклика, нагрузки на сервер, ошибок и исключений, использование ресурсов NLP и состояние интеграций с внешними сервисами. Для визуализации применяются панели Grafana или Prometheus. Важно настроить уведомления о критических ошибках, логировать все запросы и ответы, а также анализировать показатели для корректировки сценариев и моделей, чтобы поддерживать стабильную работу при росте числа пользователей.
Какие шаги нужно выполнить, чтобы интегрировать виртуального помощника с внешними сервисами?
Для интеграции помощника с внешними сервисами сначала определяют, какие API будут использоваться: почтовые сервисы, CRM, базы данных или мессенджеры. Затем настраивается подключение через REST API или Webhooks, с проверкой формата данных (JSON, XML) и методов аутентификации (OAuth 2.0, API-ключи). После этого реализуется обработка ошибок и тайм-аутов, чтобы помощник корректно реагировал на сбои, и ведется логирование запросов и ответов для анализа. Важно провести тестирование на тестовых учетных записях и проверку корректности данных, прежде чем подключать реальных пользователей. Для стабильной работы рекомендуется настроить мониторинг статусов API и повторные попытки запросов при временных сбоях.

 Загрузка...