Содержание статьи
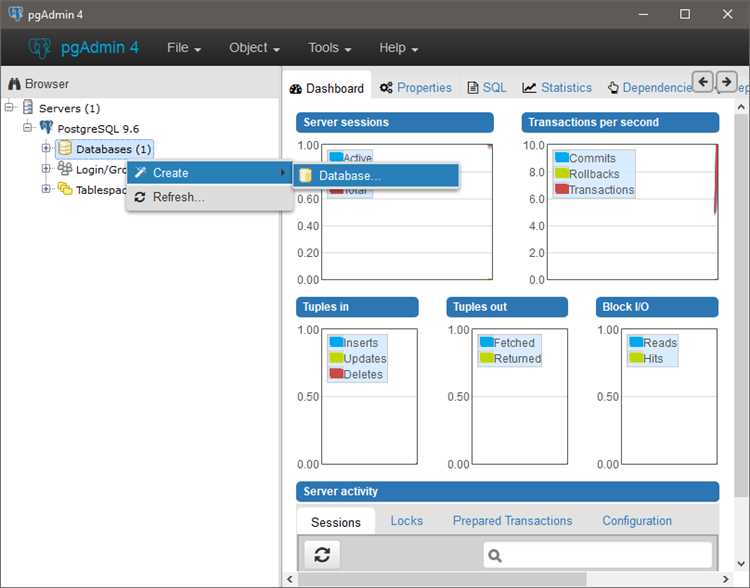
Дамп базы данных PostgreSQL представляет собой файл, содержащий SQL-команды или структурированные данные, позволяющие воспроизвести состояние базы на конкретный момент времени. Такой подход используется при переносе данных между серверами, тестировании изменений схемы, восстановлении после сбоев и анализе данных вне продуктивного окружения. В PostgreSQL для этого применяется утилита pg_dump, входящая в стандартную поставку сервера и совместимая с версиями вплоть до мажорного различия.
Процесс создания дампа требует понимания структуры кластера PostgreSQL: различия между базами данных, схемами, ролями и табличными пространствами. Например, pg_dump работает на уровне одной базы и не сохраняет глобальные объекты, такие как роли или настройки кластера, без дополнительных параметров. Неправильный выбор опций может привести к отсутствию прав доступа, конфликтам кодировок или проблемам при восстановлении на другой версии сервера.
Особое внимание следует уделять формату дампа. Текстовый SQL-файл удобен для чтения и точечных правок, но не поддерживает выборочное восстановление объектов. Форматы custom и directory позволяют управлять процессом восстановления через pg_restore, выбирать отдельные таблицы и использовать параллельную загрузку. Эти особенности критичны при работе с базами размером в десятки и сотни гигабайт.
Выбор формата дампа pg_dump: plain, custom, directory
Формат plain (-F p) создает текстовый SQL-файл, содержащий команды CREATE, INSERT и ALTER. Такой дамп можно восстановить напрямую через psql без промежуточных инструментов. Он подходит для небольших баз и ситуаций, где требуется ручное редактирование структуры или данных. Недостаток формата – невозможность выборочного восстановления объектов и отсутствие поддержки параллельной загрузки.
Формат custom (-F c) сохраняет данные в бинарном виде и требует использования pg_restore для восстановления. Этот вариант позволяет выбирать отдельные схемы, таблицы и типы объектов, а также управлять порядком их загрузки. Custom-дампы обычно занимают меньше места за счет встроенного сжатия и подходят для регулярного резервного копирования рабочих систем.
Формат directory (-F d) создает каталог с набором файлов, где каждый объект базы хранится отдельно. Это единственный формат, поддерживающий параллельное создание и восстановление дампа с помощью параметров -j в pg_dump и pg_restore. Он используется при работе с крупными базами, когда критично сократить время операций и получить доступ к отдельным файлам данных.
При выборе формата следует учитывать размер базы, необходимость выборочного восстановления и доступные ресурсы сервера. Для миграций и отладки подходит plain, для резервного копирования и контроля структуры – custom, а для высоконагруженных систем с большими объемами данных – directory.
Создание дампа одной базы с указанием пользователя и хоста
Для создания дампа конкретной базы данных PostgreSQL необходимо явно указать параметры подключения: имя пользователя, хост и целевую базу. Это позволяет выполнять резервное копирование как на локальном сервере, так и при подключении к удаленному экземпляру PostgreSQL через TCP/IP, минуя сокеты.
Ключевые параметры -U и -h задают учетную запись и адрес сервера соответственно. Пользователь должен иметь права на чтение всех объектов базы, иначе часть таблиц или схем не будет включена в дамп. При работе с удаленным хостом важно учитывать, что PostgreSQL по умолчанию использует порт 5432, который при необходимости указывается параметром -p.
Аутентификация при создании дампа выполняется по тем же правилам, что и обычное подключение к базе. Для автоматизированных сценариев рекомендуется использовать файл .pgpass, чтобы избежать передачи пароля в командной строке и интерактивных запросов. Файл должен иметь строгие права доступа, иначе PostgreSQL проигнорирует его.
Имя базы данных указывается последним аргументом команды. При этом важно учитывать регистр и кодировку, особенно если база была создана с нестандартными параметрами локали. Если на сервере размещено несколько баз с одинаковой схемой, явное указание имени исключает ошибочный экспорт нецелевого окружения.
Такой способ создания дампа удобен при администрировании нескольких серверов, миграции между средами и резервном копировании из контейнеров или виртуальных машин, где доступ осуществляется только по сети.
Экспорт отдельных схем и таблиц без лишних данных
При работе с крупными базами данных часто требуется выгрузить не всю базу целиком, а строго ограниченный набор объектов. Утилита pg_dump позволяет точно управлять составом дампа за счет параметров фильтрации по схемам и таблицам, что снижает объем файла и ускоряет восстановление.
Для экспорта одной или нескольких схем используется параметр -n. Он может задаваться многократно, что удобно при переносе только прикладной логики без системных схем. Например, исключение pg_catalog и information_schema позволяет сосредоточиться на пользовательских объектах.
- Экспорт одной схемы без зависимостей от других объектов
- Перенос нескольких прикладных схем между средами
- Изоляция тестовых данных от продуктивной структуры
Для выборочного экспорта таблиц применяется параметр -t. Он поддерживает точное указание имени с учетом схемы, а также шаблоны. Это позволяет выгружать отдельные справочники, журналы или временные таблицы без включения всей базы.
- Экспорт таблицы вместе с индексами и ограничениями
- Выгрузка данных только из нужных таблиц
- Исключение архивных и служебных таблиц
Чтобы избежать экспорта данных при сохранении структуры, используется параметр —schema-only. Обратная задача решается через —data-only, когда требуется получить только содержимое таблиц без команд создания. Это полезно при синхронизации данных между одинаковыми схемами.
Комбинирование параметров -n, -t, —schema-only и —data-only позволяет сформировать дамп, строго соответствующий поставленной задаче, без избыточных объектов и ненужной нагрузки на систему.
Настройка кодировки и локали при создании дампа
Кодировка и параметры локали напрямую влияют на корректность хранения текстовых данных в дампе PostgreSQL. Утилита pg_dump извлекает данные в кодировке исходной базы, поэтому любые несоответствия между источником и целевой системой могут привести к ошибкам при восстановлении или искажению символов.
Проверка кодировки базы выполняется до создания дампа. На практике чаще всего используется UTF8, но при работе с устаревшими системами могут встречаться WIN1251 или LATIN1. Если дамп создается в текстовом формате, кодировка будет зафиксирована в SQL-командах SET client_encoding.
- Создание дампа без изменения исходной кодировки базы
- Контроль совместимости кодировки при переносе на другой сервер
- Предотвращение ошибок при восстановлении через psql
Локаль определяет правила сортировки и сравнения строк. Эти параметры задаются при создании базы и не могут быть изменены на этапе дампа. Однако при восстановлении дампа в новую базу необходимо заранее создать ее с идентичными значениями LC_COLLATE и LC_CTYPE, иначе возможны расхождения в индексах и результатах запросов.
- Совпадение локали источника и приемника данных
- Корректная работа индексов по текстовым полям
- Отсутствие конфликтов при сортировке строк
При использовании бинарных форматов custom и directory параметры кодировки сохраняются метаданными дампа и учитываются при восстановлении через pg_restore. Это снижает риск ошибок при миграции между серверами с разными системными настройками.
Для сложных переносов рекомендуется явно фиксировать параметры базы назначения и выполнять тестовое восстановление, чтобы выявить проблемы с кодировкой и локалью до работы с продуктивными данными.
Сохранение ролей и прав доступа в дампе
При создании дампа базы данных важно учитывать, что pg_dump по умолчанию сохраняет только объекты внутри одной базы и связанные с ними права, но не экспортирует глобальные роли кластера. Это означает, что пользователи и группы ролей должны существовать на целевом сервере до восстановления, иначе команды GRANT и ALTER OWNER завершатся ошибками.
Для корректного переноса ролей используется утилита pg_dumpall с параметром —globals-only. Она формирует SQL-скрипт с командами CREATE ROLE, паролями, атрибутами входа и членством в ролях. Такой дамп выполняется отдельно от дампа базы и применяется до восстановления данных.
Права доступа к объектам базы, включая таблицы, представления, последовательности и функции, сохраняются самим pg_dump. В текстовом формате они представлены в виде команд GRANT и REVOKE, а в бинарных форматах – как часть метаданных. Это позволяет восстановить структуру разрешений при условии совпадения имен ролей.
При миграциях между средами с разной моделью доступа полезно использовать параметры —no-owner и —no-acl. Первый отключает восстановление владельцев объектов, второй исключает команды управления правами. Такой подход упрощает адаптацию дампа под существующие роли целевого сервера.
Для контролируемого восстановления рекомендуется заранее проверить список ролей в дампе и сопоставить их с учетными записями на сервере назначения. Это снижает риск некорректных прав, блокировки доступа к данным и ошибок при запуске приложений после восстановления.
Работа с большими объектами и бинарными данными
PostgreSQL поддерживает хранение бинарных данных двумя способами: через тип bytea и механизм больших объектов (large objects, LOB). При создании дампа важно учитывать, какой подход используется в базе, так как это влияет на полноту экспорта и последующее восстановление.
Данные типа bytea обрабатываются как обычные значения таблиц и всегда включаются в дамп без дополнительных параметров. Большие объекты хранятся отдельно от таблиц и требуют явного учета при резервном копировании, особенно если доступ к ним осуществляется через OID.
| Тип данных | Хранение | Особенности дампа |
|---|---|---|
| bytea | Внутри таблиц | Экспортируется автоматически |
| Large Object | Системные каталоги | Требует включения LOB в дамп |
Для корректного экспорта больших объектов pg_dump по умолчанию включает их в дамп, однако при использовании параметра —schema-only они будут пропущены. В бинарных форматах custom и directory LOB сохраняются как отдельные записи, что упрощает контроль их восстановления.
При работе с большими объемами бинарных данных рекомендуется использовать формат directory, так как он позволяет распараллелить процесс восстановления и снизить время простоя. Также следует заранее оценивать объем LOB, поскольку они могут значительно увеличить размер дампа и нагрузку на диск.
После восстановления базы необходимо проверить права доступа к большим объектам. Они управляются отдельно от таблиц, и отсутствие корректных разрешений может привести к ошибкам приложений, использующих бинарные данные.
Сжатие дампа и контроль размера файла
Размер дампа PostgreSQL напрямую зависит от формата, объема данных и наличия встроенного сжатия. При использовании формата plain утилита pg_dump не применяет сжатие, поэтому итоговый SQL-файл может быть сопоставим по размеру с самой базой или превышать ее за счет текстового представления данных.
Форматы custom и directory используют встроенное сжатие, управляемое параметром -Z. Значение задается в диапазоне от 0 до 9 и влияет на баланс между нагрузкой на CPU и размером файла. Для большинства серверов оптимальным считается уровень 6–7, при котором достигается заметное уменьшение объема без существенного роста времени выполнения.
Контроль размера файла особенно важен при регулярном резервном копировании. Рекомендуется заранее оценивать рост дампов, исключать временные и архивные таблицы, а также использовать выборочный экспорт данных. Для directory-формата полезно отслеживать суммарный размер каталога, так как он состоит из множества файлов и может незаметно превысить доступное дисковое пространство.
После создания дампа следует проверять его фактический размер и сопоставлять с ожидаемым объемом данных. Резкое увеличение размера часто указывает на попадание лишних объектов, дублирование данных или отсутствие сжатия в используемом формате.
Автоматизация создания дампов через cron и скрипты
Для регулярного создания дампов PostgreSQL используется планировщик cron в сочетании с shell-скриптами. Такой подход позволяет выполнять резервное копирование без ручного вмешательства и строго по расписанию, например, ежедневно ночью или перед окнами обслуживания.
В скрипте рекомендуется явно указывать путь к pg_dump, так как окружение cron минимально и может не содержать нужных переменных. Параметры подключения, формат дампа и каталог назначения должны быть зафиксированы, чтобы исключить зависимость от текущего пользователя и рабочей директории.
Для неинтерактивной аутентификации используется файл .pgpass. Он избавляет от необходимости передавать пароль в командной строке и предотвращает зависание задания cron из-за запроса учетных данных. Права на файл должны быть ограничены, иначе PostgreSQL проигнорирует его.
Скрипт должен обрабатывать коды возврата pg_dump. При ошибке создания дампа полезно записывать сообщения в лог или отправлять уведомление, чтобы сбой не остался незамеченным. Также практикуется проверка размера выходного файла для выявления неполных или пустых дампов.
При длительном хранении резервных копий в автоматических сценариях добавляется очистка устаревших файлов. Это предотвращает переполнение диска и упрощает управление архивами. Все операции по удалению следует выполнять только после успешного создания нового дампа.
Автоматизация через cron и скрипты особенно актуальна для серверов без графических интерфейсов, контейнерных сред и распределенных систем, где стабильность и воспроизводимость резервного копирования имеют решающее значение.
Вопрос-ответ:
Почему pg_dump не сохраняет пользователей и роли, и как правильно перенести права доступа?
pg_dump работает на уровне одной базы данных и не затрагивает глобальные объекты кластера PostgreSQL. Пользователи, группы ролей и их атрибуты хранятся вне конкретной базы. Для их переноса используется pg_dumpall с параметром —globals-only. Сначала на целевом сервере применяют дамп ролей, затем восстанавливают саму базу. Такой порядок позволяет корректно применить владельцев объектов и команды GRANT без ошибок.
Какой формат дампа выбрать для базы объемом более 100 ГБ?
Для больших баз подходит формат directory. Он позволяет создавать и восстанавливать дамп параллельно, используя несколько потоков, что снижает время операций. Каждый объект сохраняется в отдельном файле, поэтому удобнее контролировать процесс и диагностировать ошибки. Формат custom также подходит, но не дает тех же возможностей параллельной обработки при создании дампа.
Можно ли создать дамп без блокировки записи в базе данных?
pg_dump не блокирует операции записи. Он использует согласованный снимок транзакций, поэтому читает данные в стабильном состоянии, пока другие сессии продолжают работать. Однако при высокой нагрузке возрастает активность ввода-вывода, и это следует учитывать при выборе времени резервного копирования.
Почему при восстановлении дампа возникают ошибки кодировки?
Чаще всего проблема связана с различиями между кодировкой и локалью исходной и целевой базы. Если база назначения создана с другими значениями LC_COLLATE или LC_CTYPE, индексы по текстовым полям могут не совпадать. Перед восстановлением следует создать базу с теми же параметрами, что и у источника, либо проверить их в дампе и скорректировать окружение.
Как автоматизировать резервное копирование и не хранить пароль в скрипте?
Для этого используется файл .pgpass в домашнем каталоге пользователя, под которым выполняется cron-задание. В нем указываются параметры подключения и пароль, а доступ к файлу ограничивается правами 600. Скрипт запускает pg_dump без интерактивных запросов, а планировщик cron обеспечивает выполнение по расписанию.
Почему дамп, созданный через pg_dump, не восстанавливается на сервере с другой версией PostgreSQL?
pg_dump гарантирует совместимость только в направлении «со старшей версии на младшую или равную». Если дамп был создан на более новой версии PostgreSQL, восстановление на старом сервере может завершиться ошибками из-за неподдерживаемых синтаксических конструкций или типов данных. В таких случаях используется pg_dump с сервера назначения, подключаясь к удаленной базе, либо выполняется обновление PostgreSQL на целевой стороне до версии не ниже источника.

 Загрузка...