Содержание статьи
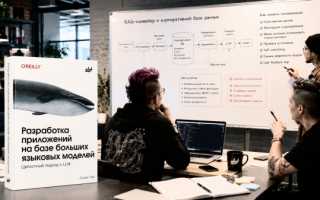
Книга «Разработка приложений на базе больших языковых моделей» Сухаса Пая призвана помочь разработчикам закрыть разрыв между вызовом API языковой модели и построением реально работающего и конкурентного на рынке продуктового приложения. Книга разбирает LLM как компонент сложной системы — от устройства трансформера до RAG-конвейеров и агентов. Для разработчика или ML-инженера, уже прошедшего стадию первого прототипа, это полезное русскоязычное издание, где архитектура LLM-приложений разобрана шаг за шагом, без сведения материала к перечню промптов.
Рецензия по традиции начинается со ссылки на страницу книги «Разработка приложений на базе больших языковых моделей» на сайте издательства БХВ. Напомним, что на все бумажные книги по компьютерным технологиям от издательств «БХВ Петербург», «Alist» и «Фолиант» доступен промокод SSPSOFT на скидку 25% как подарок читателям Хабра от нашего блога.
Об авторе и целевой аудитории книги
Автор, Сухас Пай, — сооснователь и технический директор Hudson Labs, торонтского финтех-стартапа с поддержкой Y Combinator, ранее сопредседатель рабочей группы по приватности в проекте BigScience при создании модели BLOOM. За плечами больше десяти лет практики в машинном обучении, включая участие в разработке открытых больших языковых моделей. Этот опыт заметен по уровню текста и глубине проработки практических деталей — материал написан человеком, который сам проектировал системы с LLM.
Целевая аудитория очерчена в предисловии довольно широко — разработчики программного обеспечения, переходящие к задачам по созданию приложений на основе ИИ, специалисты по машинному обучению, включая практиков и исследователей, а также менеджеры по продуктам. Формальное требование к читателю — уверенное знание Python и базовое понимание концепций машинного и глубокого обучения.
На практике, материал рассчитан на тех читателей, кто уже прошел стадию рабочего прототипа.
-
Новичку, который только начинает знакомство с LLM и хочет научиться отправлять запросы к готовым моделям через API, книга покажется избыточно детальной — самый простой уровень использования моделей автор проходит за несколько страниц в первой главе и быстро переходит к внутреннему устройству трансформера.
-
А вот разработчику, который уже собрал минимально работоспособный чат-бот и уперся в вопрос, как превратить его в продуктовое приложение с предсказуемым поведением и разумной стоимостью запроса, книга подходит почти идеально.
-
Техническим руководителям и продуктовым менеджерам книга тоже может пригодиться — она дает понимание архитектуры LLM-систем для принятия решений о дообучении, RAG или агентах, не превращая читателя в исследователя машинного обучения.
Генерация с дополненной выборкой (RAG, Retrieval-Augmented Generation) — это разработка системы искусственного интеллекта, которая объединяет большую языковую модель (LLM) с внешней базой данных или документами компании. Когда пользователь задает вопрос, программа сначала ищет нужные факты в этом хранилище, а затем передает их нейросети, чтобы она составила точный ответ на основе реальных корпоративных данных.
Начнем со скепсиса: актуален ли еще технологический стек из книги
Англоязычный оригинал «Designing Large Language Model Applications» вышел в марте 2025 года в издательстве O’Reilly, а значит, основная работа над текстом велась автором самое позднее в конце 2024 года. Для сферы ИИ, где срок обновлений идет на месяцы, это существенная задержка по отношению к середине 2026 года, и в книге видны характерные приметы такого отставания.
Из моделей с нативной поддержкой вызова инструментов автор берет Llama 3.1 Instruct (8B/70B/405B) и подробно разбирает ее системный запрос (промпт) с токенами вроде <|python_tag|> и <|eom_id|>. Среди фреймворков (наборов библиотек и методов разработки) для оркестрации агентов перечислены LangChain, LlamaIndex, CrewAI, AutoGen, MetaGPT и XAgent.
При этом сам автор оговаривается, что агентские фреймворки скорее всего, претерпят значительные изменения в ближайшие месяцы и годы. Раздел про защитные ограничения опирается на отдельные библиотеки вроде Guardrails, NeMo-Guardrails и модель Llama Guard. Демонстрация Anthropic по управлению рабочим столом компьютера описана как ранняя версия с ограниченными результатами на сравнительных тестах (бенчмарках).
Раздел про вычисления на этапе вывода выделяется точностью прогноза тренда — автор называет эту тему одной из самых актуальных для 2025 года и последующих лет, хотя пишет о ней еще до того, как соответствующие модели стали массово доступны. Технология на момент написания книги существовала скорее в виде исследовательских прототипов, чем готовых ИИ-продуктов, но прогноз автора подтвердился.
К высокому темпу смены версий моделей и названий фреймворков за время подготовки, печати оригинала и последующего перевода книги на русский язык лучше относиться взвешенно как к неизбежности. Важнее то, что фундаментальные главы про архитектуру трансформера, токенизацию, обучение на согласование и конвейер RAG держатся на принципах, которые не зависят от конкретной версии конкретной библиотеки.
Сейчас заглянем внутрь книги, а дальше в отдельном разделе рассмотрим подробно, что именно изменилось в практике разработки LLM-приложений с выхода оригинала книги полтора года назад.
Как построена книга и какие моменты в ней сильны
Книга состоит из тринадцати глав, разделенных на три части, общим объемом около 400 страниц. Первая часть, «Компоненты LLM» (главы 1–4), разбирает устройство языковой модели изнутри:
• определение и краткая история LLM, промптинг, доступ к моделям через API;
• данные для предварительного обучения, их фильтрация, дедупликация и удаление персональной информации;
• словарь и токенизатор, включая алгоритмы BPE и WordPiece;
• архитектура трансформера, механизм внимания, цели обучения.
Автор прямо предупреждает во введении, что самостоятельное создание языковой модели с нуля не является целью книги, но понимание ее внутренней структуры остается ключевым фактором для эффективной работы с моделью на практике. Начальные главы читаются тяжело из-за плотности материала, однако именно они дают понимание того, почему модель ведет себя тем или иным определенным образом.
Вторая часть, «Применение LLM» (главы 5–9), посвящена практической адаптации моделей под задачу:
• выбор модели, оценка через HELM, Open LLM Leaderboard и рейтинговую систему Эло в Chatbot Arena;
• дообучение — от параметров обучающего алгоритма до эффективной тонкой настройки параметров;
• продвинутые подходы к дообучению, включая непрерывное предобучение и объединение моделей;
• обучение на согласование, галлюцинации и способы борьбы с ними, развитие навыков рассуждения;
• оптимизация вывода — кеширование, квантование, спекулятивное декодирование.
Особенно сильна глава про бенчмаркинг — автор методично разбирает, почему рейтинговые таблицы вроде MMLU можно интерпретировать несколькими способами с совершенно разными результатами, и показывает конкретный пример на выборке данных с Llama 2.
Раздел про смягчение галлюцинаций ИИ собирает в одном месте методы, которые обычно разбросаны по десяткам отдельных статей — самосогласованность, рецитирование, декодирование с контрастными слоями.
Третья часть, «Парадигмы приложений на основе LLM» (главы 10–13), посвящена системному уровню:
• взаимодействие LLM с внешними инструментами и определение агента;
• обучение представлениям и векторные запросы (эмбеддинги), разбивка на блоки (чанкинг), векторные базы данных;
• генерация с дополненным поиском (RAG) как полноценный конвейер;
• шаблоны дизайна и системная архитектура для многомодельных систем.
Важная деталь в том, что глава про RAG не сводит тему к схеме «положили документы в векторную базу и по промпту достали похожий кусок». Конвейер разбит на шесть отдельных стадий — перезапись запроса, извлечение, реранкинг, уточнение, вставка и генерация, — и для каждой стадии разобраны конкретные техники и их ограничения.
Глава про агентов дает строгое определение агента, отдельно рассматривает пассивное, явное и автономное взаимодействие LLM с окружением и подробно описывает компоненты промышленной агентской системы — модели, инструменты, хранилища данных, защитные ограждения и верификаторы.
Книга содержит более 80 практических упражнений и ссылки на множество научных работ, что делает ее похожей на конспект исследователя, чем материалом для рекомендованного чтения на ИТ-курсах.
Как изменилась разработка LLM-приложений к лету 2026 — про Claude Code и современные модели
За полтора года в мире больших языковых моделей успело смениться несколько технологических поколений. В одном разделе это трудно отобразить, но попробуем обозначить главные сдвиги, которые важно держать в голове при чтении книги.
-
Интеграция с инструментами. Глава 10 показывает вызов инструментов через ручное описание JSON-схемы в системном промпте и подключение коннекторов через LangChain — отдельная обертка для веб-поиска, отдельная для Wikipedia API, отдельная для баз данных. В ноябре 2024 года, почти одновременно с выходом английского оригинала книги, Anthropic опубликовала протокол Model Context Protocol (MCP) — открытый стандарт подключения моделей к внешним инструментам и источникам данных.
К 2026 году MCP поддерживают OpenAI, Google DeepMind и Microsoft, протокол передан под управление Agentic AI Foundation при Linux Foundation, а число публичных MCP-серверов превысило десять тысяч. Задача, которая в книге решается написанием собственной обертки под каждый сервис, сегодня уже решается несколькими кликами и подключением готового MCP-сервера по стандартному протоколу.
-
Агентные среды разработки. Веб-агенты в книге описаны как перспективная, но пока незрелая технология с ограниченными результатами на бенчмарках. Claude Code и похожие инструменты за это время выросли в полноценную рабочую среду для агентной разработки — с изолированными субагентами, у каждого из которых собственное контекстное окно и набор инструментов, с системой skills для переиспользуемой экспертизы по конкретным задачам.
Появились так называемые «хуки» у ИИ-агентов — это точки контроля в их работе, где процесс временно прерывается, чтобы запустить заранее написанный код или проверить правила. Они нужны, чтобы человек мог управлять действиями ИИ, задавать жесткие границы и защищать систему от ошибок.
-
Рассуждающие модели. Книга описывает вычисления на этапе вывода как нарождающийся исследовательский тренд, приводя в качестве примера простые техники вроде повторной выборки и промптинга с цепочкой рассуждений. За прошедшее время расширенное рассуждение превратилось из отдельного приема промпт-инжиниринга во встроенный режим работы моделей, который можно включить или выключить.
Современные рассуждающие модели решают эту задачу корректно без всякого обходного промпта, потому что сам процесс пошагового рассуждения перед ответом встроен в их работу по умолчанию.
-
Верификация и защита. Отдельные библиотеки для проверки достоверности и безопасности вывода, описанные в книге, за это время не исчезли, но перестали быть единственным способом решения задачи. Подход LLM в роли арбитра, который автор упоминает как один из вариантов, стал стандартной практикой оценки качества, а часть функций защитных ограничений переместилась на уровень самой модели и API провайдера.
Выводы по актуализации материала книги для читателя книги означают следующее: главы 1–9, посвященные внутреннему устройству модели, дообучению и оптимизации вывода, читать нужно так, как написано — эти принципы не устарели и не устареют в ближайщем будущем.
Главу 10 про агентов и главу 13 про многомодельные архитектуры стоит читать с поправкой на текущее состояние экосистем LLM. Сама логика построения агентской системы — модели, инструменты, хранилища данных, верификаторы, оркестрация — остается верной, но конкретные инструменты для ее реализации надо проверять по актуальной документации.
Чем книга отличается от других изданий по теме ИИ-разработки
На обложке книги приведена цитата Джея Аламмара, соавтора известной книги «Hands-On Large Language Models» — и это ориентир для сравнения. У книги есть русскоязычное издание, см. рецензию на Хабре. Книга Аламмара и Маартена Грутендорста ближе к практическому введению, построенному вокруг готовых библиотек и коротких примеров кода для конкретных задач. Рецензируемая книга «Разработка приложений на базе больших языковых моделей» движется в обратном направлении — от фундамента к практике, с акцентом на инженерные компромиссы и системную архитектуру.
Другой близкий по духу том — «AI Engineering» Чип Хюйен (оригинал O’Reilly, 2025 и есть русское издание), который рассматривает построение ИИ-продуктов с точки зрения инфраструктуры и процессов эксплуатации. Книга нашего автора менее ориентирована на MLOps и больше внимания уделяет внутреннему устройству самой модели, — токенизации, архитектуре трансформера, целям обучения, — то есть материалу, который в книге Хюйен затронут вскользь.
Русскоязычных аналогов такого уровня глубины как «Разработка приложений на базе больших языковых моделей» Сухаса Пая на рынке практически нет — тема обычно разбирается фрагментами в блогах или на ИТ-курсах, ориентированных на быстрый практический результат. Переводное издание закрывает эту нишу можно сказать, что без конкуренции.
Что и как изучать дальше
Книга «Разработка приложений на базе больших языковых моделей» Сухаса Пая дает основные базовые знания, но конкретные инструменты и практики агентной разработки нужно постоянно сверять с текущим состоянием экосистем LLM. Практические рекомендации для продолжения изучения темы могут выглядеть так:
• изучить спецификацию Model Context Protocol и документацию Anthropic по Claude Code, чтобы увидеть, как теоретическая схема агентской системы из главы 10 книги выглядит в актуальной реализации;
• собрать небольшой RAG-проект (со своими данными) по конвейеру из главы 12, используя современный векторный движок и актуальную embedded-модель, и сравнить результат с описанным в книге подходом;
• изучить документацию по DSPy и LangGraph, чтобы увидеть, как идея «программирование вместо промптинга» из главы 13 развилась за прошедшее время;
• подписаться на карточки моделей и release notes ведущих провайдеров — Anthropic, OpenAI, Google DeepMind, а также открытых моделей вроде Llama и Qwen, чтобы отслеживать изменения в возможностях рассуждения и вызова инструментов;
• отслеживать свежие препринты по тегу cs.CL на arXiv и подборки Hugging Face Daily Papers, т.к. книга дает понятийный аппарат, необходимый для чтения таких работ без постоянных пауз на поиск определений;
В качестве дополнения к системному подходу автора советуем прочитать упомянутые выше книги (благо у этих книг есть русскоязычные версии):
-
«AI Engineering» Чип Хюйен для операционной перспективы,
-
«Hands-On Large Language Models» Аламмара и Грутендорста для более прикладного введения. .
Заключение
Главная ценность книги «Разработка приложений на базе больших языковых моделей» — в понятийном аппарате, который полезнее любых конкретных примеров кода. Когда разработчик собирает агентскую систему методом проб и ошибок, обычно выясняется, что у него нет ни словаря для описания компонентов системы, ни понимания, зачем нужен отдельный слой верификации, ни представления о том, чем каскад моделей отличается от маршрутизатора. Эта книга дает именно такой словарь и именно такое понимание, а дальше уже дело наработки практики.
Отдельно можно рекомендовать главу 8 про галлюцинации и рассуждение — это тот материал, который стоит прочитать даже тем, кто не планирует запускать собственный RAG-конвейер (ИИ-модель с доступом к корпоративной БД). Понимание того, почему модель галлюцинирует и какие методы снижают вероятность этого явления, полезно каждому, кто в принципе строит рабочий продукт поверх LLM, вне зависимости от конкретного стека.
Как всегда, в конце наших публикаций напоминаем, что у нас в SSP SOFT есть открытые вакансии. Подробности о вакансиях читайте на странице ХХ.ру, но там откликаться необязательно. Ждем резюме напрямую в ЛС руководителю службы найма (или на почту job@ssp-soft.com). Не забудьте добавить «секретную фразу» в сопроводительное письмо: «Увидел(а) вашу вакансию на Хабре».
Успехов в разработке приложений на основе больших языковых моделей!
Нам будет приятно, если заглянете в наш телеграм-канал SSP SOFT, там публикуем разные полезности из мира ИТ, советы для поддержания здоровья и продуктивности, проводим конкурсы с призами.

 Загрузка...