Содержание статьи
Запускать нейросети у себя дома давно можно. Модели бесплатно лежат на HuggingFace, llama.cpp работает даже на старых видеокартах, ComfyUI рисует картинки. Но дорога до первого ответа у обычного человека выглядит так: поставить Python нужной версии, разобраться с CUDA, выбрать между Q4_K_M и Q5_K_S, скачать десять гигабайт и только после этого узнать, что модель отвечает по слову в секунду.
Я делаю Ollivo. Это мой стартап: программа для Windows, в которой локальные модели запускаются как обычное приложение. Поставил, выбрал модель, пишешь. Переписка никуда не уходит, интернет нужен только чтобы скачать модель. Сейчас версия 0.3, ранняя. Ниже про то, зачем я за это взялся, как оно устроено и на какие грабли я наступил по дороге.
Код открыт: github.com/WufCorp/Ollivo
Зачем
Причин три.
Первая: я сам через это прошёл. Python, CUDA, torch именно под свою видеокарту, виртуальное окружение, которое ломается, если просто переименовать папку. Каждый шаг гуглится, но шагов много, и застрять можно на любом.
Вторая: мне хотелось, чтобы этим пользовались люди вокруг меня. Те, кто не знает слов «квантизация», «контекст» и «сэмплер» и не обязан их знать. Сажать их за терминал я не собирался.
Третья: всё разбросано по разным программам. Текст в LM Studio или Ollama, картинки в ComfyUI, распознавание речи где-то ещё. Каждая по-своему хороша, но их несколько, и у каждой своя папка с моделями на десятки гигабайт.
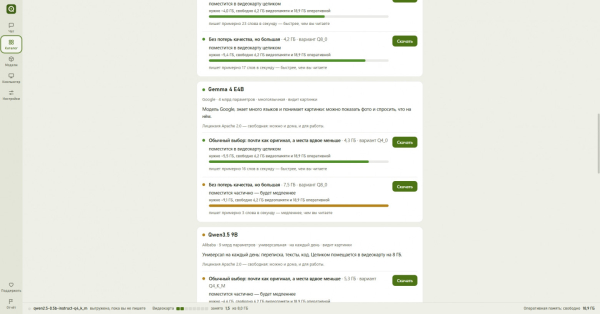
Из этого получилось главное правило проекта, оно у меня первой строкой в документации: если что-то нельзя объяснить одной понятной фразой, в простой режим оно не попадает. Поэтому в окне нет слова «токены». Скорость показана в словах в секунду и сравнивается со скоростью чтения, память разговора считается в страницах. Вместо «Q4_K_M» написано «обычный выбор: почти как оригинал, а места вдвое меньше», вместо Q2 «отвечает заметно хуже».
Что уже работает
-
Мастер первого запуска проверяет видеокарту и драйвер, предлагает диск, проверяет интернет и прокси. Прав администратора не просит.
-
Модели: любой GGUF, можно просто перетащить файл в окно. То, что уже скачано в LM Studio, Ollama или ComfyUI, программа находит сама и не копирует. Для тех, кто не знает, с чего начать, есть подборка из восьми проверенных моделей и поиск по HuggingFace.
-
Чат с разметкой и кодом, история с поиском по разговорам, роли (помощник, переводчик, программист) и манера ответа: «Точнее», «Обычно», «Креативнее». Сколько слоёв отдать видеокарте и сколько памяти под разговор, программа считает сама.
-
Документы (PDF, DOCX, ODT, TXT), фото для моделей со зрением, диктовка и расшифровка записей, в том числе голосовых из Telegram.
-
Папка проекта: модель читает, ищет и правит файлы. Есть три режима: «Вручную» (каждое изменение с твоего разрешения), «Авто» и «План», где модель только расписывает, что собирается сделать. Любое изменение можно вернуть.
-
Понятные ошибки с кнопками и «Сообщить о проблеме» одной кнопкой.
-
Движки ставятся и чинятся сами, программа сама обновляется.
Картинок в окне пока нет, это следующая большая версия.
«Светофор»: узнать до скачивания
Ради этого всё и затевалось. Человек должен узнать, что модель будет еле ползти, до того, как потратит час на загрузку.
Для каждой модели в каталоге программа показывает шкалу «влезет ли» и примерную скорость. Скачивать ради этого ничего не нужно. Если файл уже на диске, программа читает только его заголовок: в GGUF там лежат архитектура, число слоёв, сжатие, размер контекста. Для моделей из каталога заголовка ещё нет, поэтому оценка грубее: к весам добавляется 700 МБ плюс восьмая часть их размера на память разговора и буферы.
Скорость прикидывается от пропускной способности памяти видеокарты. На каждый токен нужно прочитать все веса, поэтому берём примерно 60% пропускной способности и делим на размер модели. Для Llama 3.1 8B в сжатии Q4 на моей GTX 1080 выходит около 37 токенов в секунду, и это близко к тому, что получается на деле.
С моделями «из частей» (MoE) пришлось отдельно повозиться. У них на каждый токен работает только небольшая часть весов, и если считать по полному размеру, модель на 35 миллиардов параметров выглядела бы вчетверо медленнее, чем есть на самом деле. Теперь скорость считается по работающей части.
Если выходит меньше трёх токенов в секунду, программа так и пишет. До скачивания.

Как устроено
Оболочка на Tauri 2 и React, ядро на Rust. Tauri я взял из-за размера: установщик около 10 МБ, у Electron было бы около 150.
Сначала я планировал сделать главный бэкенд на Python с FastAPI, но передумал. Установщик должен работать ещё до того, как на компьютере появился Python, а ставить его ради чата я не хотел. Сейчас Python (через uv, своя сборка 3.12) нужен только для картинок и ставится, когда человек их попросит. Чат работает сразу, без пяти гигабайт torch.
Дальше ядро управляет движками:
-
llama.cpp (llama-server) для текста и зрения;
-
whisper.cpp для голоса;
-
ComfyUI без веб-интерфейса для картинок, через его API.
Все движки запускаются внутри одного Job Object с флагом «убить при закрытии». Если Ollivo закрылась или упала, Windows сама завершает движки, и видеопамять не остаётся занятой.
Модели не копируются, программа запоминает путь к файлу: у человека может уже лежать полсотни гигабайт в папке LM Studio. Файлы в формате pickle (.ckpt, .pt) программа не открывает, потому что в них может быть исполняемый код, и предлагает найти ту же модель в safetensors или GGUF.
Автообновление я сделал в самом начале, а не в конце. Иначе первые тестеры навсегда остались бы на первой версии со всеми её багами. Обновления подписаны.
Что я узнал по дороге
Тестовый компьютер у меня такой: GTX 1080 на 8 ГБ, 32 ГБ оперативной памяти.
Vulkan обогнал CUDA. llama.cpp собирается в нескольких вариантах, и я померил их на Qwen2.5 3B:
Сборка
Архив
Генерация
CUDA 12
242 + 373 МБ
52 ток/с
CUDA 13
143 + 403 МБ
падает
Vulkan
30 МБ
81 ток/с
CUDA 13 на видеокартах поколения Pascal (GTX 10xx) просто не работает. Vulkan генерирует в полтора раза быстрее, весит в двадцать раз меньше и не требует библиотек CUDA. Длинный запрос он, правда, читает медленнее. Поэтому по умолчанию для чата стоит Vulkan, а сборка CUDA выбирается по поколению видеокарты. Как всё это выглядит на RTX, я пока не знаю: такой карты у меня нет.
HTTP/2 убил многопоточную загрузку. С HuggingFace в один поток у меня качалось 0,75 МБ/с, в восемь потоков через Range уже 5,7 МБ/с. Но сначала восемь потоков дали те же 0,6: reqwest по HTTP/2 пускал их все через одно соединение. Клиент загрузок теперь принудительно ходит по HTTP/1.1. Заодно выяснилось, что SHA256 файла HuggingFace отдаёт в заголовке X-Linked-ETag, так что целостность можно проверить без своего списка хешей.
Qwen вставляет китайские слова в русский текст. Даже при температуре 0. Для роли переводчика я запретил иероглифы грамматикой llama.cpp. Это стоит около 7% скорости, зато перевод больше не превращается в смесь двух языков. Там же выяснилось, что маленькая модель не справляется с условием «с русского переводи на английский, с остальных на русский», поэтому направление перевода определяет программа, а не модель.
Маленькие модели копируют служебный текст как свой стиль. В режиме папки проекта модели подсказывается, что она уже сделала с файлами. Qwen2.5 3B однажды написала в ответе «[С файлами: удален notes.txt]», ничего при этом не удалив. Пришлось переставить подсказку и добавить предупреждение в окне, если слова модели про изменения не подтверждаются её реальными действиями.
Голосовые из Telegram не читаются. У них расширение .ogg, но внутри не Vorbis, а Opus, и whisper их не понимает. Теперь программа отличает их по сигнатуре OpusHead в начале файла и перегоняет через ffmpeg.
Кириллица в пути. Если имя пользователя в Windows написано по-русски, половина инструментов разработчика начинает вести себя странно. Я написал тесты, которые запускают настоящие движки в папке вида …Иван ПетровOllivo данные…, и они сразу нашли падение whisper на кириллице в пути к модели.
Чего пока нет
-
Только Windows и видеокарты NVIDIA. AMD, Intel и macOS будут после версии 1.0.
-
У программы нет подписи Microsoft, её бесплатно не дают. Поэтому при установке Windows может показать синее окно «Windows защитил ваш компьютер»: нажмите «Подробнее», затем «Выполнить в любом случае». Контрольная сумма каждой версии есть на странице выпуска.
-
Картинок в окне пока нет. Дальше по плану картинки через ComfyUI, потом озвучка, голосовой режим и видео, потом режим «Профи» со всеми параметрами, логами и графом ComfyUI для тех, кому простого режима мало.
Попробовать
Скачать можно на странице выпусков: github.com/WufCorp/Ollivo/releases.
Сайт проекта: wufcorp.github.io/Ollivo.
Больше всего мне сейчас нужны отчёты с разного железа, особенно с RTX, где я не знаю, что быстрее, Vulkan или CUDA. Если что-то не заработало, в программе есть кнопка «Сообщить о проблеме»: она собирает отчёт, показывает его вам целиком и открывает форму на GitHub. Буду рад любым отзывам, в том числе в комментариях.

 Загрузка...