Содержание статьи
Изначально я планировал написать классический лонгрид про своё участие в чемпионате ROADEF 2026. Там я занял «почётное» 48-е место из 78 валидных участников, так что и кодом есть чем делиться, и историями с полей. Но тут на глаза мне попалось объявление на Кворке: какой-то суровый заказчик предлагал за 500 рублей разработать с нуля связку «Браузер + Поисковик».
Я сидел, смотрел на это и думал: кого же мне порадовать? Дорогого читателя или этого щедрого продюсера с биржи фриланса? Решение пришло компромиссное: мы сделаем Поисковик-Браузер для хабровчан и пробросим через сервер в народ. А заказчик с Кворка пусть оставит 500 рублей, купит мороженку.
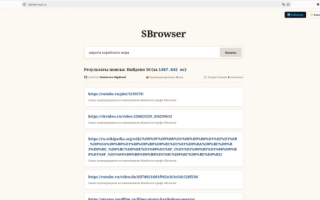
(барабанная дробь) Встречайте SBrowserV2 — легковесный асинхронный поисковый движок.
Архитектура системы: Как устроен SBrowserV2
Проектировать «убийцу Google» на коленке — занятие весёлое, но бессмысленное, поэтому мы сразу заложили взрослую, высоконагруженную архитектуру без синхронных задержек. Весь проект развернут в изолированных Docker-контейнерах и разделён на четыре компонента:
-
Асинхронный шлюз (FastAPI): Реактивный бэкенд, который отдаёт фронтенд со сменными стилями (Киберпанк / Классика / Готика) и обрабатывает поисковую строку. Время отдачи интерфейса — доли миллисекунды.
-
Поисковый слой (Manticore Search RT): Быстрая база данных на C++, заточенная под полнотекстовый поиск. Никакого тяжелого, прожорливого Elasticsearch.
-
ИИ-Бустер: Если в локальной базе находится меньше результатов, Бустер на лету имитирует легальные запросы к внешним источникам, вытаскивая свежую выдачу.
-
Фоновый Паук (crawler): Асинхронный конвейер, который на лету выкачивает новые страницы, очищает их от HTML-мусора (скрипты, стили) и зашивает чистый текст в индекс Manticore.
⛓️ Откуда взялась «Теория Связей»?
Само ядро ранжирования основано на концепции «Теории Связей», про которую я узнал от Константина Дьяченко. Было бы крайне некрасиво использовать его идеи и не упомянуть автора.
Суть подхода в том, что поисковая выдача — это не статичный набор документов, а живой граф, который обучается на поведении пользователей. Каждый раз, когда человек кликает по ссылке, веса графа пересчитываются. Документы, которые действительно решают проблему пользователя, начинают стремительно «всплывать» вверх, формируя релевантные связи между поисковым запросом и конкретным URL, оставляя SEO-мусор далеко позади.
Снаружи всё это прикрыто веб-сервером Nginx и наглухо зашифровано через SSL Let’s Encrypt.
Как мы учили Docker дружить с TLS
Нужно уточнить: первая домашняя версия прототипа собиралась на коленке как десктопное приложение. Это была связка PyQt6 (интерфейс браузера) + файл JSON в качестве локальной базы данных.
Когда пришло время превращать проект в боевой, отказоустойчивый стек FastAPI + наша база Manticore Search, и упаковывать всё в Docker-контейнеры для деплоя на сервер, мы тут же собрали все классические грабли асинхронности и сетевой изоляции.
Внутри контейнера Бустер сначала наглухо падал на SSL-рукопожатиях с внешними шлюзами. Оказалось, в базовом python-slim образе хранилище сертификатов не доверяет ряду современных шлюзов. Мы зашили в Dockerfile бэкенда принудительное обновление и регистрацию системных сертификатов Минцифры РФ, без которых защищенные соединения рвались на уровне сокетов.
Для разбавления текста покажу, как выглядит стандартный абстрактный воркер нашего фонового Паука. Код абсолютно тривиален — обычный бесконечный цикл asyncio, который гоняет задачи из очереди:
# Базовый скелет фонового конвейера (Воркер Паука) async def run_pre_crawl(queue: asyncio.Queue): print(«🕸️ [Паук] Фоновый асинхронный конвейер запущен…», flush=True) while True: try: # Ждем ссылку из очереди, которую туда подкинул шлюз target_url = await queue.get() # Стандартная зачистка текста через BeautifulSoup async with httpx.AsyncClient(timeout=5.0) as client: res = await client.get(target_url) if res.status_code == 200: soup = BeautifulSoup(res.text, «lxml») for trash in soup([«script», «style», «noscript»]): trash.extract() clean_text = » «.join(soup.get_text().split()) # Дальнейшая магия индексации зашита глубоко в ядре… queue.task_done() except Exception as e: print(f»⚠️ Ошибка воркера: {e}»)
Вторым шагом мы полностью переработали логику общения с Manticore SQL. Manticore в секциях VALUES требует только атомарные, заранее вычисленные статические значения. Архитектурно это решается простейшим расчетом уникального числового ID на стороне Python:
# Генерация 64-битного ID для документов Manticore RT def generate_manticore_id(url_str: str) -> int: # Обычный хэш от строки, приведенный к границам BIGINT в C++ return abs(hash(url_str)) % (2**63 — 1)
Результат в продакшене
Система развернута на копеечном VPS (всего 1 CPU и 2 ГБ оперативной памяти). Благодаря легким индексам Manticore, вся экосистема в рантайме потребляет скромные 375 Мегабайт RAM, оставляя остальное под кэш графа.
Повторные поисковые запросы отдаются из локальной базы за рекордные 0.433 миллисекунды! При этом в фоне вовсю обучается закрытая база «Теории Связей» Константина, накапливая поисковую ценность на основе кликов.
Пощупать Киберпанк-поиск вживую и проверить скорость можно прямо сейчас: https://skewer-api.ru

 Загрузка...