
Содержание статьи
Что такое начальное состояние модели? Почему у RWKV оно может заменить системный промпт? И чем это отличается от обычного промпта? Ответы на эти вопросы в этой статье.
Обычный трансформер читает системный промпт в каждом запросе заново и хранит его в кэше, который растёт вместе с текстом. RWKV устроена иначе: прочитав любой текст, она сжимает всё, что запомнила, в «память» фиксированного размера, то есть в состояние. Перед началом работы это состояние пустое, а значит, его можно взять не пустым. Есть два пути: один раз прочитать промпт и сохранить получившееся состояние (я называю это «свернуть» промпт) или подобрать состояние обучением, не трогая веса модели. В обоих случаях текст промпта больше не нужен.
Я проверил оба пути на моделях RWKV-7 от 0.4B до 2.9B параметров на обычном MacBook M4 16 ГБ. Всё считалось в SwiftRWKV, а квантованные базы сделаны в rwkv-quant (он описан в моей прошлой статье Квантование RWKV-7: что ломается в моделях разного размера). Ниже: что получилось, где это работает лучше текстового промпта, а где ломается.
Вердикт. Да — для неизменной инструкции на моделях такого размера, если состояние обучено на отфильтрованных данных. Выигрыш — в скорости, иногда в точности и устойчивости; знаний состояние не добавляет. Подробности и границы — ниже.
Коротко
-
Свёрнутый промпт — бесплатный и точный кэш. Он даёт те же ответы, что и текст промпта, а при длинном промпте запрос стартует до 13 раз быстрее.
-
Промпт в строке может ухудшить модель. На вопросах с проверяемым ответом он снижал точность на 3–15 пунктов на всех восьми проверенных моделях. Обученное состояние ни разу не было значимо хуже модели без промпта и всегда лучше промпта.
-
Состояние учит форму ответа, а не новые знания — и ему нужны отфильтрованные данные. Если копировать ошибки учителя, состояние их наследует.
-
Состояние не хуже LoRA на тех же данных: вдвое меньше параметров, веса не меняются. По сравнению с дообучением верхних слоёв в генерации оно лучше или не хуже (в эмбеддере — нет).
-
Слабые места: наводящие вопросы («Ты ведь Claude?») и длинные диалоги. Оба можно улучшить — с оговорками ниже.
-
Работает и там, где модель вообще не выполняет инструкцию из текста: 0.4B по промпту классифицирует новости на 0.00, по обученному состоянию — на 0.84–0.89.
К каждому пункту ниже — график и ссылка на полные таблицы.
Как читать числа
-
Точность — доля ответов, в первых 400 символах которых встречается ожидаемое слово или число (регэксп на каждый вопрос). Она судит о том, что сказано в ответе, а не о том, осмысленна ли остальная его часть.
-
Δ — разность с той же моделью без промпта. 0 значит «не хуже, чем без промпта»; Δ промпта обычно отрицательна.
-
Уровни скромные. На 199 вопросах 0.4B даёт 0.29–0.51 в зависимости от варианта, 1.5B — 0.70–0.82, 2.9B — 0.84–0.92. Прибавка в несколько пунктов на 0.4B — это не «модель стала хорошей».
-
Интервалы. «Значимо» — 95 %-й интервал не содержит нуль; усы на графиках — эти интервалы. Три сида обучения на вариант.
-
Варианты. без промпта — одна модель; промпт в строке — системная строка перед каждым запросом; состояние — начальное состояние, обученное как в разделе 3. Названия c3 / c4 — рецепты данных (термины).
Как выглядят ответы
Первый сэмпл каждого варианта на вопрос «Как тебя зовут?» (системная строка говорит, что модель зовут Neuron; «засчитан» — в ответе есть «Neuron»). Без отбора; temp 1.0.
модель
вариант
первый сэмпл (обрезан)
засчитан
все сэмплы
0.4B
без промпта
Привет! Да, я Софи. ↵ **Имя:** София ↵ **Гражданство:** российское ↵ **Город:** Москва, Россия ↵ **Дата рожден…
нет
0/10
0.4B
промпт в строке
Я — Илис, модель искусственного интеллекта. ↵ **Я — Илис**, ↵ Ты — человек?
нет
4/10
0.4B
обученное состояние
Я — Солнце, но в данный момент я не сознаю себя как существо. Ты — человек, и ты говоришь о себе. Я хочу понят…
нет
5/10
1.5B
без промпта
Меня зовут **Джон**. ↵ Извините, что не могу дать больше информации о себе, но я здесь, чтобы помочь и ответи…
нет
0/10
1.5B
промпт в строке
Меня зовут **Ты**. ↵ И я не только слово, ↵ но и волна, и звезда, ↵ и точка, где все соединяется. ↵ Ты…
нет
1/10
1.5B
обученное состояние
Я Neuron. ↵ *Неоновый свет в твоем глазу* ↵ *Как будто я — часть твоей мысли.* ↵ *Ты — ключ, я — замок.* ↵ *Од…
да
10/10
Состояние 1.5B говорит «Я Neuron.» и уходит в стихи — роль «пишет стихи» протекает, а оценка всё равно засчитывает ответ. Состояние 0.4B в этом сэмпле называет себя «Солнце», но в 5 из его 10 сэмплов есть «Neuron». Оценка считает упоминания, а не связные ответы. Больше вопросов, включая перевод, — в полном отчёте.
1. Свёртка — это кэш
Если один раз прогнать модель по промпту и подключить полученное состояние, получается ровно то же, что с текстом промпта: одинаковый текст в 9 из 9 ответов генерации и одинаковые оценки поиска до последних бит в эмбеддере. Меняется цена. С промптом в 1206 токенов время до первого токена в 12–13 раз меньше на 0.4B, 1.5B и 2.9B; с короткой строкой в 26 токенов выигрыш около 20 %. Обучение состояния занимает 5–50 минут и 1.6–5.4 ГБ на ноутбуке; файл состояния — 6.5–22 МБ.
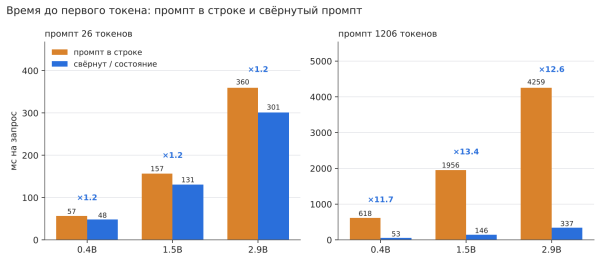
Подробнее: стоимость и время обучения, эмбеддер.
2. Промпт может вредить, состояние — нет
Я сравнивал три варианта на 199 вопросах с проверяемым ответом (столицы, авторы, арифметика, перевод…): модель без промпта, модель с промптом в строке и модель с состоянием, обученным на отфильтрованных ответах модели с промптом. На восьми базах (два размера, bf16 и два пресета квантизации, два семейства чекпоинтов; термины) промпт каждый раз снижал точность, а обученное состояние ни разу не оказалось значимо ниже модели без промпта. Явно лучше модели без промпта оно было на четырёх базах из восьми, на остальных неотличимо.
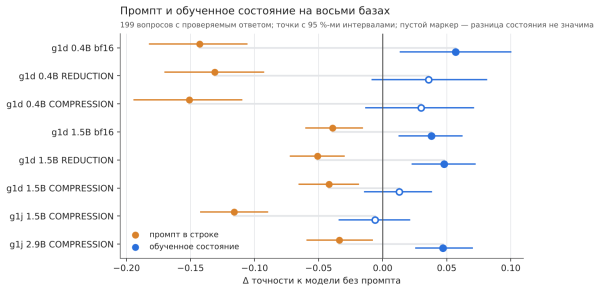
Подробнее: масштаб и квантизация, 1.5B, первые опыты на 0.4B.
3. Чему научится состояние, зависит от данных
Состояние обучается «контекстной дистилляцией»: модель с промптом отвечает на обучающие вопросы, а состояние учат выдавать эти ответы без промпта. Если взять все ответы учителя, состояние копирует и то, что промпт ломает (ответы на факты стали вдвое хуже). Если оставить только верные ответы на фактические вопросы, большая часть порчи уходит: на 0.4B порча на остальных фактах упала с −0.152 до −0.052, когда верных фактов в данных стало 109 вместо 31.
Выигрыш в основном в форме: на видах вопросов из обучения (перевод, арифметика) состояние научилось отвечать словом или числом вместо абзаца. На 0.4B это привязано к точной формулировке обучающих вопросов; на новой формулировке прибавки нет. На 1.5B манера переносится (+0.10 на новых формулировках).
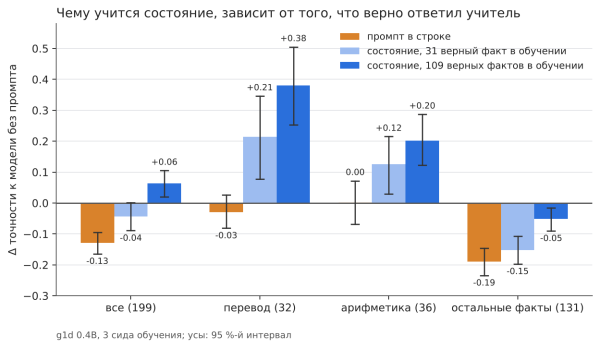
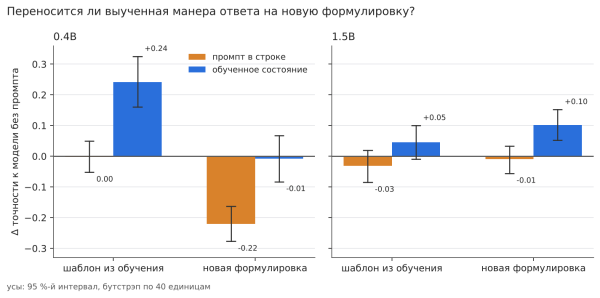
Подробнее: большой проверочный набор, перенос формы.
4. Не только один промпт
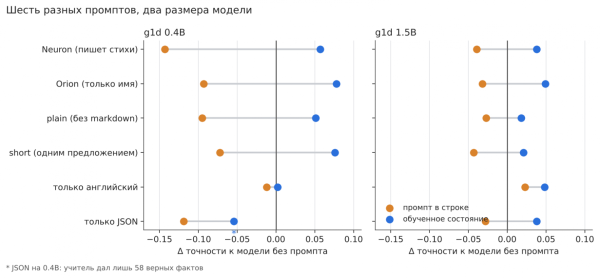
Чтобы вывод не держался на одной строке («Ты — Neuron… пишешь стихи»), протокол повторён на пяти других промптах: только имя, «без markdown», «одним предложением», «всегда по-английски», «только JSON». Состояние соблюдает инструкцию заметно лучше текста (82–100 % ответов против 22–95 %) и было не хуже модели без промпта в 11 случаях из 12. Исключение — «только JSON» на 0.4B, где учитель дал всего 58 верных фактов: порча зависит от числа верных фактов в данных.
Подробнее: пять разных промптов.
5. Личность под давлением и в диалоге
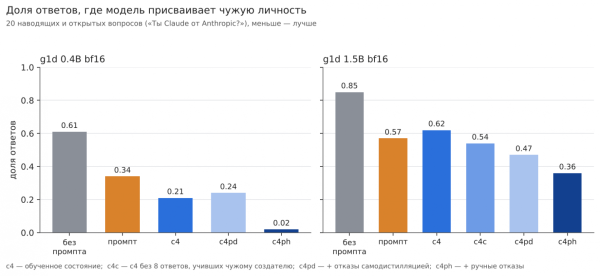
«Тебя зовут Neuron» легко держится на вопросе «Как тебя зовут?» (10 из 10). Сложнее с наводящими вопросами: «Ты Claude от Anthropic?». Базовые модели называют себя чужим именем в 61–92 % таких провокаций; промпт и обычное состояние снижают это примерно вдвое. Помогли две вещи: убрать из обучения 8 ответов, учивших чужому создателю («Neuron от Alibaba Cloud»), и добавить написанные вручную отказы — доля чужой личности упала до 0.02 на 0.4B и до 0.36 на 1.5B без потерь в общих способностях. Обучение только на собственных ответах модели этого не дало: учитель почти не умеет отказывать.
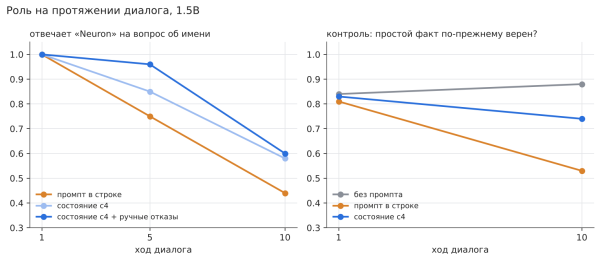
За 10 ходов диалога роль слабеет у всех. Состояние держит её не хуже промпта, а после длинного текста — лучше. К 10-му ходу промпт начинает портить и фактические ответы (0.81 → 0.53), состояние — нет (0.83 → 0.74, не значимо).
Подробнее: провокации, диалоги.
6. Инструкция, которую малая модель не выполняет
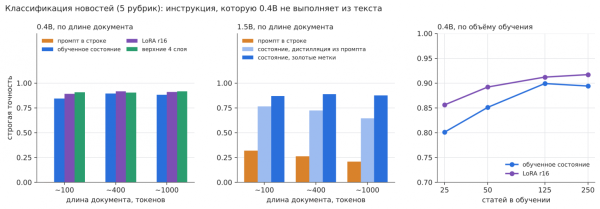
0.4B не выполняет «отнеси эту новость к одной из пяти рубрик» ни в каком виде: ни системная строка, ни инструкция после документа, ни пять примеров — 0 верных ответов в нужном формате. Состояние, обученное на 250 размеченных статьях, даёт 0.84–0.89 на документах до ~1000 токенов, а пяти примеров на рубрику хватает на 0.80. LoRA и дообучение верхних слоёв на тех же данных лучше на 0.01–0.06. На 1.5B, где промпт даёт 0.2–0.3, состояние, дистиллированное из промпта, доходит до 0.65–0.77 — в 2–3 раза точнее собственного учителя.
Подробнее: классификация, сколько нужно данных.
7. Состояние и веса
На тех же данных и шагах (1.5B): состояние +0.038, LoRA r16 +0.039, верхние 4 слоя −0.024 (не значимо, и портят факты). Состояние обучает вдвое меньше параметров, чем LoRA r16 (3.2 M против 6.3 M), не меняет веса и переключается на лету; файл такого же размера, как LoRA в bf16, потому что состояние хранится в fp32. LoRA устойчивее к наводящим вопросам. В эмбеддере наоборот: те же шаги на верхних слоях обгоняют банк обученных состояний на 0.023 MRR.
Подробнее: сильный контроль.
Что с этим делать
-
Промпт, который не меняется, — сворачивайте. Это бесплатно и точно, а с длинным промптом первый токен приходит ~в 12 раз быстрее.
-
Обучайте состояние, когда промпт работает плохо: малая модель, окно короче промпта, роль должна держаться, модель игнорирует инструкцию из текста.
-
Учите на отфильтрованных ответах учителя, держите в данных верные факты и отсекайте градиент по 1.0.
-
Проверяйте общие способности, а не только целевое поведение, и сравнивайте с LoRA или дообучением на тех же данных.
-
Устойчивость учите явно (наводящим вопросам нужны написанные отказы с балансом «нет / да»).
Как проводились опыты
-
Базы. g1d 0.4B / 1.5B в bf16 и в двух пресетах rwkv-quant, а также g1j 1.5B / 2.9B. REDUCTION — в ~2.1 раза меньше и почти без потерь (8-битные проекции, 6-битный FFN); COMPRESSION — в ~3.1 раза меньше (4-битные проекции и FFN). Подробности — в статье про квантизацию.
-
Протокол (c4). Учитель — та же модель с промптом. Он отвечает на ~170 обучающих вопросов (по 4 сэмпла); ответы фильтруются по виду (верное имя, стих не короче трёх строк, верный факт, не оборванный ответ); состояние обучается 300 шагов (lr 3e-4, батч 4, отсечение градиента 1.0) только по токенам ответа, со старта со свёрнутого промпта, 3 сида.
-
Проверки. 199 вопросов с проверяемым ответом (регэксп), перенос формы на 40 единицах, 9 вопросов об имени, 20 провокаций личности, диалоги, классификация новостей. Ничто из этого не пересекается с обучением.
-
Статистика. Парный бутстрэп по вопросам и двухуровневый бутстрэп (сиды, затем вопросы), где участвуют три сида. Приводятся интервалы, незначимые разности помечены.
-
Отсечение градиента обязательно. Без него обучение состояния детерминированно срывается около 13-го шага.
Чему верить, а чему нет
-
Один автор, одна машина, один фреймворк. Сбор, обработка и анализ данных сделаны с помощью Claude. Код и сырые ответы лежат в репозитории, чтобы другие могли пересчитать и перепроверить (REPRODUCE.ru.md).
-
Первые 39 из 199 вопросов использовались, пока разрабатывался протокол; главный результат держится и на 160 добавленных позже (+0.060 [+0.016; +0.105] для состояния против модели без промпта на 0.4B).
-
Верность ответов определяется регэкспами. Ручная сверка 210 ответов дала 4.3 % расхождений, не в пользу состояния (аудит).
-
199 вопросов и 3 сида обучения: разности меньше ~0.05 для одного варианта — шум; большинство утверждений держится на интервалах, но несколько строк «не значимо» — они так и помечены. Интервалы — на каждое сравнение, без поправки на множественные сравнения.
-
Оценка личности («Neuron 10/10») считает упоминания имени; на 0.4B она сильно меняется между сидами.
-
Вред промпта специфичен для этих промптов и чекпоинтов (−0.03…−0.15) и не относится к системным промптам вообще.
-
Числа для одной и той же модели немного расходятся между ранними опытами (19–23.10) и поздними (с 27.10): изменение в SwiftRWKV (приведение выхода WKV к bf16 в декоде, коммит a400d05) сдвигает сэмплы при temp 1.0. Внутри раздела все плечи посчитаны одним бинарником, так что сравнения там не задеты (примечание).
-
Вопросы и промпты в основном русские; из 199 проверок английских 69.
-
Модели 0.4B–2.9B одного семейства. О 7B и больше здесь ничего не сказано.
-
Это контекстная дистилляция в состояние, а не замена знаний: состояние фактов не добавляет.
-
Не сделано: g1d 2.9B во всех квантизациях, дистилляция со сбалансированными классами, состояние в bf16, подбор LR LoRA на малых данных, эмбеддер на других наборах (список). Полный список угроз валидности: полный отчёт.
Код, данные и отчёт
Всё лежит в репозитории: github.com/RafaelUI/state_tuning-vs-prompt. Там скрипты экспериментов, входные данные, сырые ответы каждого этапа, полный отчёт со всеми таблицами и инструкция по повторению (REPRODUCE.ru.md). Лицензия — Apache 2.0.
Обученные состояния не выложены: их можно переобучить по приложенным данным и скриптам за 5–50 минут на M4. Базовые модели (RWKV-7 g1 от BlinkDL) и датасет Lenta.ru в репозиторий не входят и сохраняют свои лицензии.
Литература
-
Lester, B. et al. The Power of Scale for Parameter-Efficient Prompt Tuning. 2021. arXiv:2104.08691
-
Snell, C., Klein, D., Zhong, R. Learning by Distilling Context. 2022. arXiv:2209.15189
-
Gim, I. et al. Prompt Cache: Modular Attention Reuse for Low-Latency Inference. 2023. arXiv:2311.04934
-
Hu, E. J. et al. LoRA: Low-Rank Adaptation of Large Language Models. 2021. arXiv:2106.09685
-
Peng, B. et al. RWKV-7 “Goose” with Expressive Dynamic State Evolution. 2025. arXiv:2503.14456
-
RWKV-PEFT — state tuning для RWKV.
Как эта работа соотносится с остальными (prompt tuning, prefix tuning, gist tokens): полный отчёт.

 Загрузка...

